قبل أن تبدأ
إستعملْ كشف الجسمِ عندما لاي كاي يَجِبُ أَنْ يَكتشفَ حيث الجسم على الشاشةِ. تصنيف الصور يجيب فقط على ما تحتويه صورة كاملة ولا يعيد صندوقاً مقيداً
هذا الدليل يأخذك من طلقات الشاشة الخام إلى نموذج "لاي كاي" قابل للمقارنة وهي تستخدم مجموعة بيانات حقيقية عن لعبة صغيرة كمثال على العمل، ولكن العملية نفسها تنطبق على ضوابط التطبيق والمنتجات والمقاييس والأدوات وغيرها من الأهداف البارزة. (ONNX)
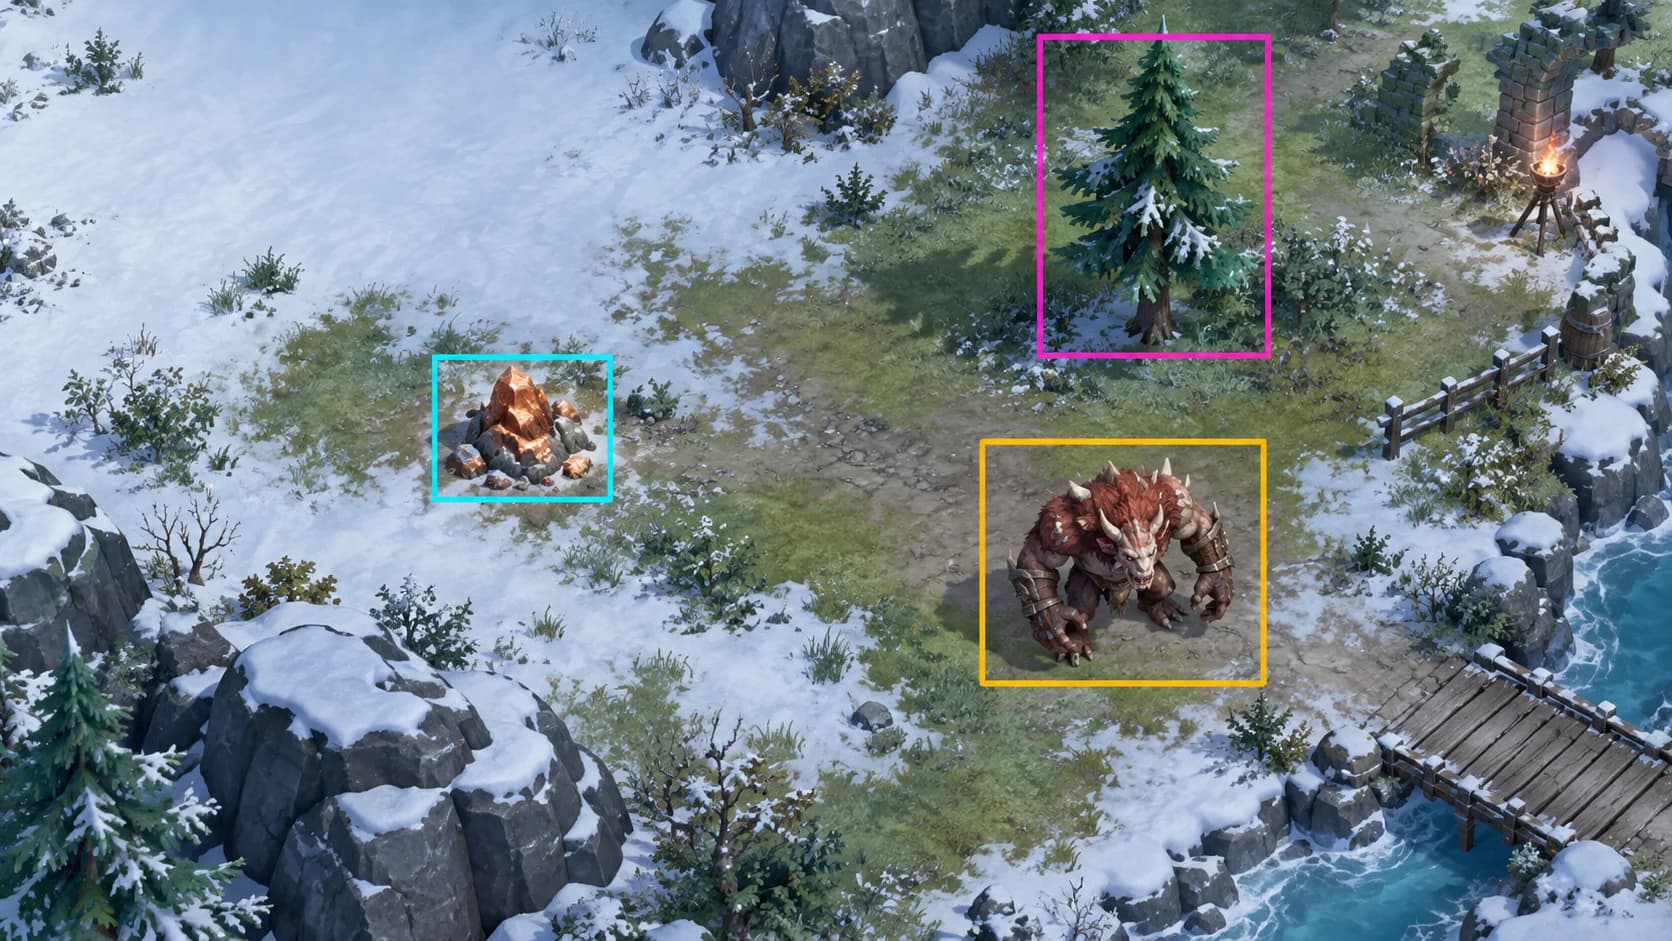
إستعملْ كشف الجسمِ عندما لاي كاي يَجِبُ أَنْ يَكتشفَ حيث الجسم على الشاشةِ. تصنيف الصور يجيب فقط على ما تحتويه صورة كاملة ولا يعيد صندوقاً مقيداً
عادة نعم عندما يظهرون في نفس اللعبة أو التطبيق، يستعملون نفس مقياس الشاشة، ويحتاجون لأن يكتشفوا في نفس التدفق. ولا تكون هناك نماذج منفصلة إلا عندما تكون المشاهد غير متصلة، تصبح قائمة الفصول كبيرة جدا، أو تحتاج مجموعة واحدة إلى مدخل مختلف أو هدف للأداء.
جمع الإطارات من الجهاز الدقيق، والتسوية، ومستوى التكبير، والجودة البصرية التي ستراه لاي كاي. ويكتسي التنوع أهمية أكبر من توفير العديد من أطر الفيديو المتتالية التي تبدو متطابقة تقريبا.
يجب أن يمثل الفصل قراراً بصرياً واحداً يجب أن يتخذه التدفق إبقاء الأسماء قصيرة، فريدة، ومستقرة لأن نفس الطلب يستخدمYOLOالبطاقات، البيانات، والثقة، والرؤية، واختيار الصف. (vision.detect · config.json · data.yaml)
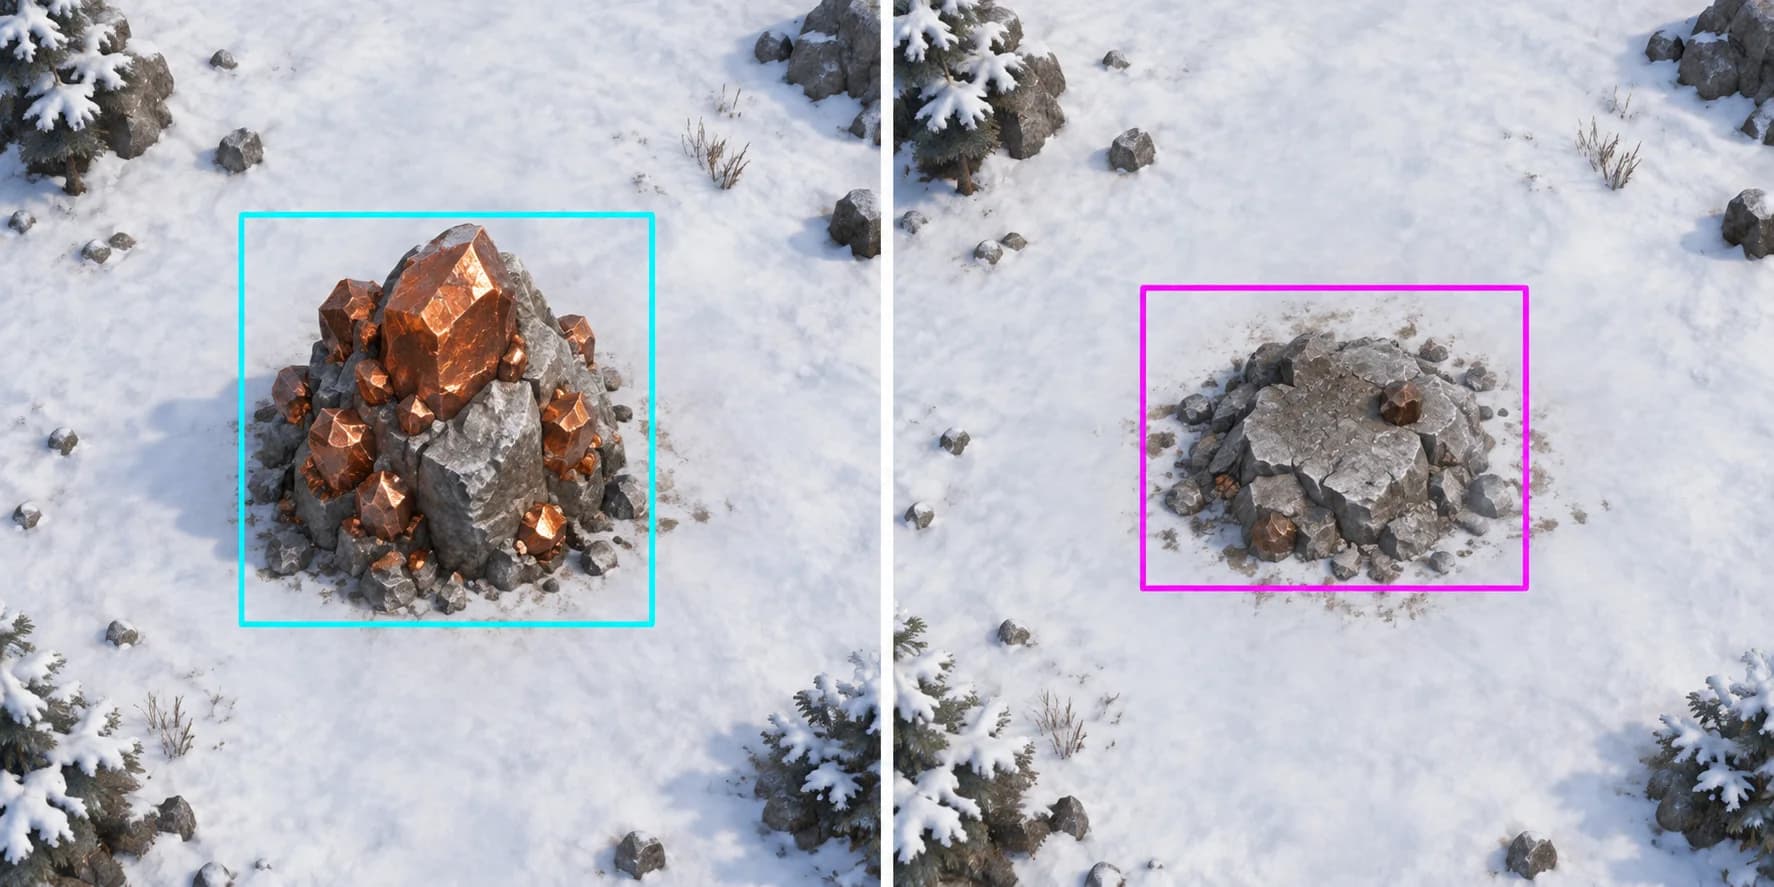
If a collected resource still resembles the available resource, label both states, for example Copper and CopperDepleted. ولا تتوقع عتبة الثقة وحدها لفصل ولايتين مرئيتين حقيقيتين بشكل موثوق.
(كيسينس آي) هو أداة توسيم قائمة على المروجين For LaiCai models, choose Object Detection, use rectangular boxes, and exportYOLOشروح (MakeSense.ai)
افتح الماكيسيس وارفع صور المصدر حافظ على ملف الصور الأصلي الخاص بك؛ والعلامة المصدرة ZIP لا يحل محله. (MakeSense.ai)
اختر كشف الأجسام وليس التعرف على الصور (Object Detection · Image Recognition)
إنشاء القائمة النهائية في ترتيب ثابت، ثم رسم تراجع حول كل حالة مستهدفة.
استعراض الصور الفارغة، الأشياء المفقودة، الفصول الخاطئة، وصناديق مفتوحة قبل التصدير.
Export Rect annotations as a ZIP package inYOLOشكل
كل صورة لها نفس اسم ملف بطاقة توكست Split by recording session or time range, not by randomly scattering adjacent video frames across train and validation.
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── data.yamlpath: /absolute/path/to/dataset
train: images/train
val: images/val
names:
0: Copper
1: CopperDepleted
2: Wood
3: MonsterA practical starting split is 80% train and 20% validation. ويجب أن تتضمن مجموعة المصادقة مشاهد غير مرئية حقا.
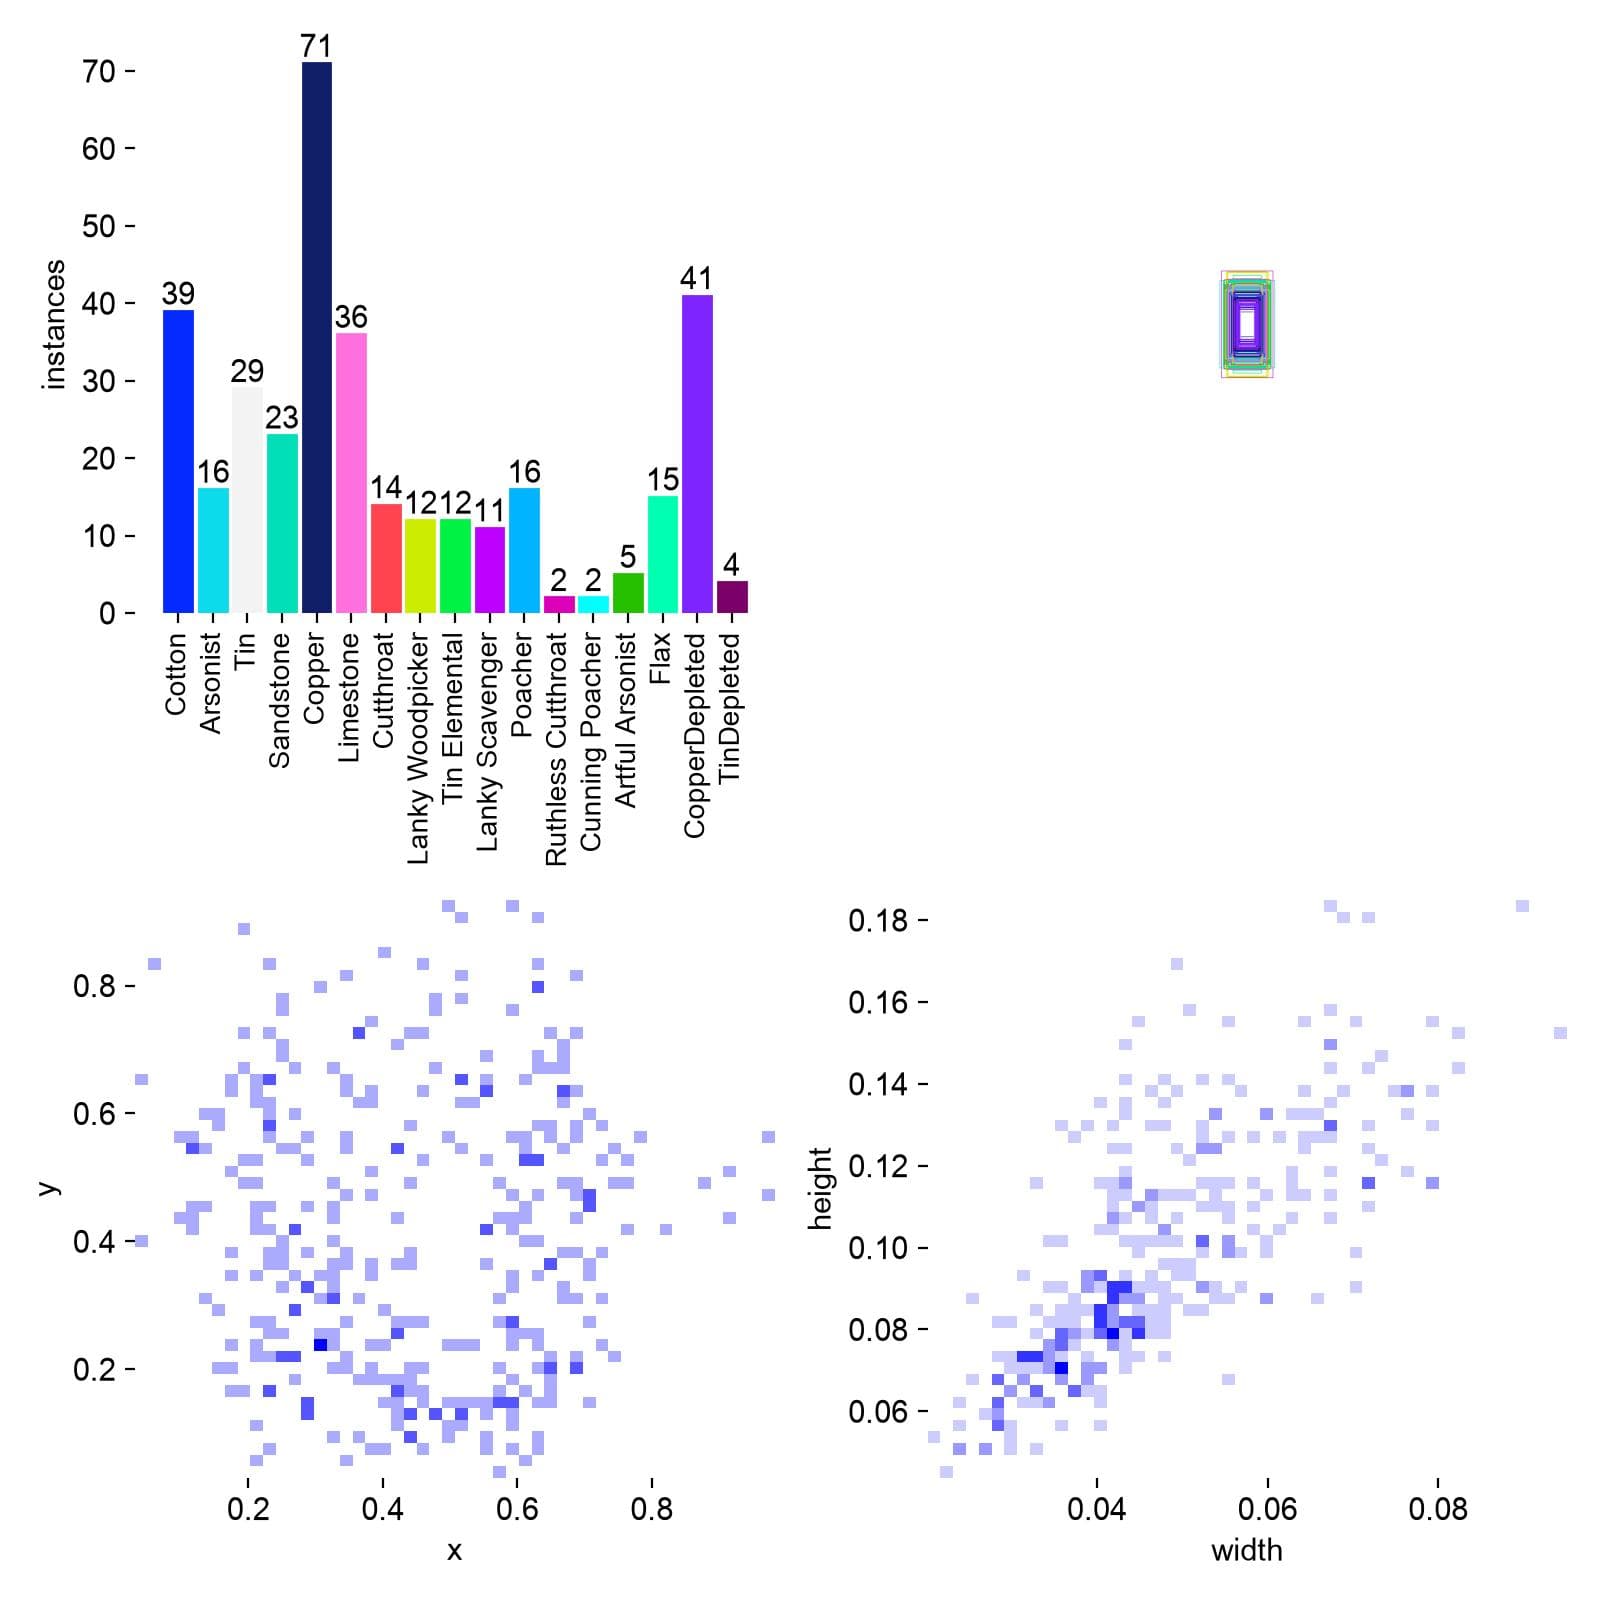
The example below uses versions verified with this workflow. نموذج نانو هو امن نقطة انطلاق للكشف المستمر استخدام 640 باكس للأجسام الكبيرة و 960 باكس عندما تكون الأهداف المهمة صغيرة.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install ultralytics==8.4.138 onnx==1.22.0 \
onnxruntime==1.29.0 onnxslim==0.1.96| البارامترات | القيمة الناشئة | لماذا |
|---|---|---|
model | YOLO26n | صغيرة وسريعة بما فيه الكفاية للضغط الأول. |
imgsz | 960 / 640 | Use 960 for small targets; use 640 when targets are larger or speed matters more. |
epochs | 200 | يضع سقفاً كريماً بينما يتوقف مبكراً يمكن أن ينتهي قريباً |
patience | 40 | ولم تتحسن حالات التوقف بعد التصديق بالنسبة لأربعين نقطة. |
batch | 8 | خفض إلى 4 أو 2 إذا نفذت الذاكرة؛ ولا تزيد إلا بعد القياس. |
device | mps / 0 / cpu | (أبل سيليكون) يستخدم (أمبير) و (نيفيدا) يستخدم صفراً و أي آلة يمكن أن تستخدم (كبو) |
workers | 4 | نقطة انطلاق متحفظة |
seed | 42 | ويسهل استنساخ البيانات ومقارنات التدريب. |
close_mosaic | 15 | المصابون بالهزاء قرب النهاية حتى يشاهدون صوراً طبيعية أكثر |
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="dataset/data.yaml",
    imgsz=960,
    epochs=200,
    patience=40,
    batch=8,
    device="mps",  # NVIDIA: 0 · CPU: "cpu"
    workers=4,
    seed=42,
    close_mosaic=15,
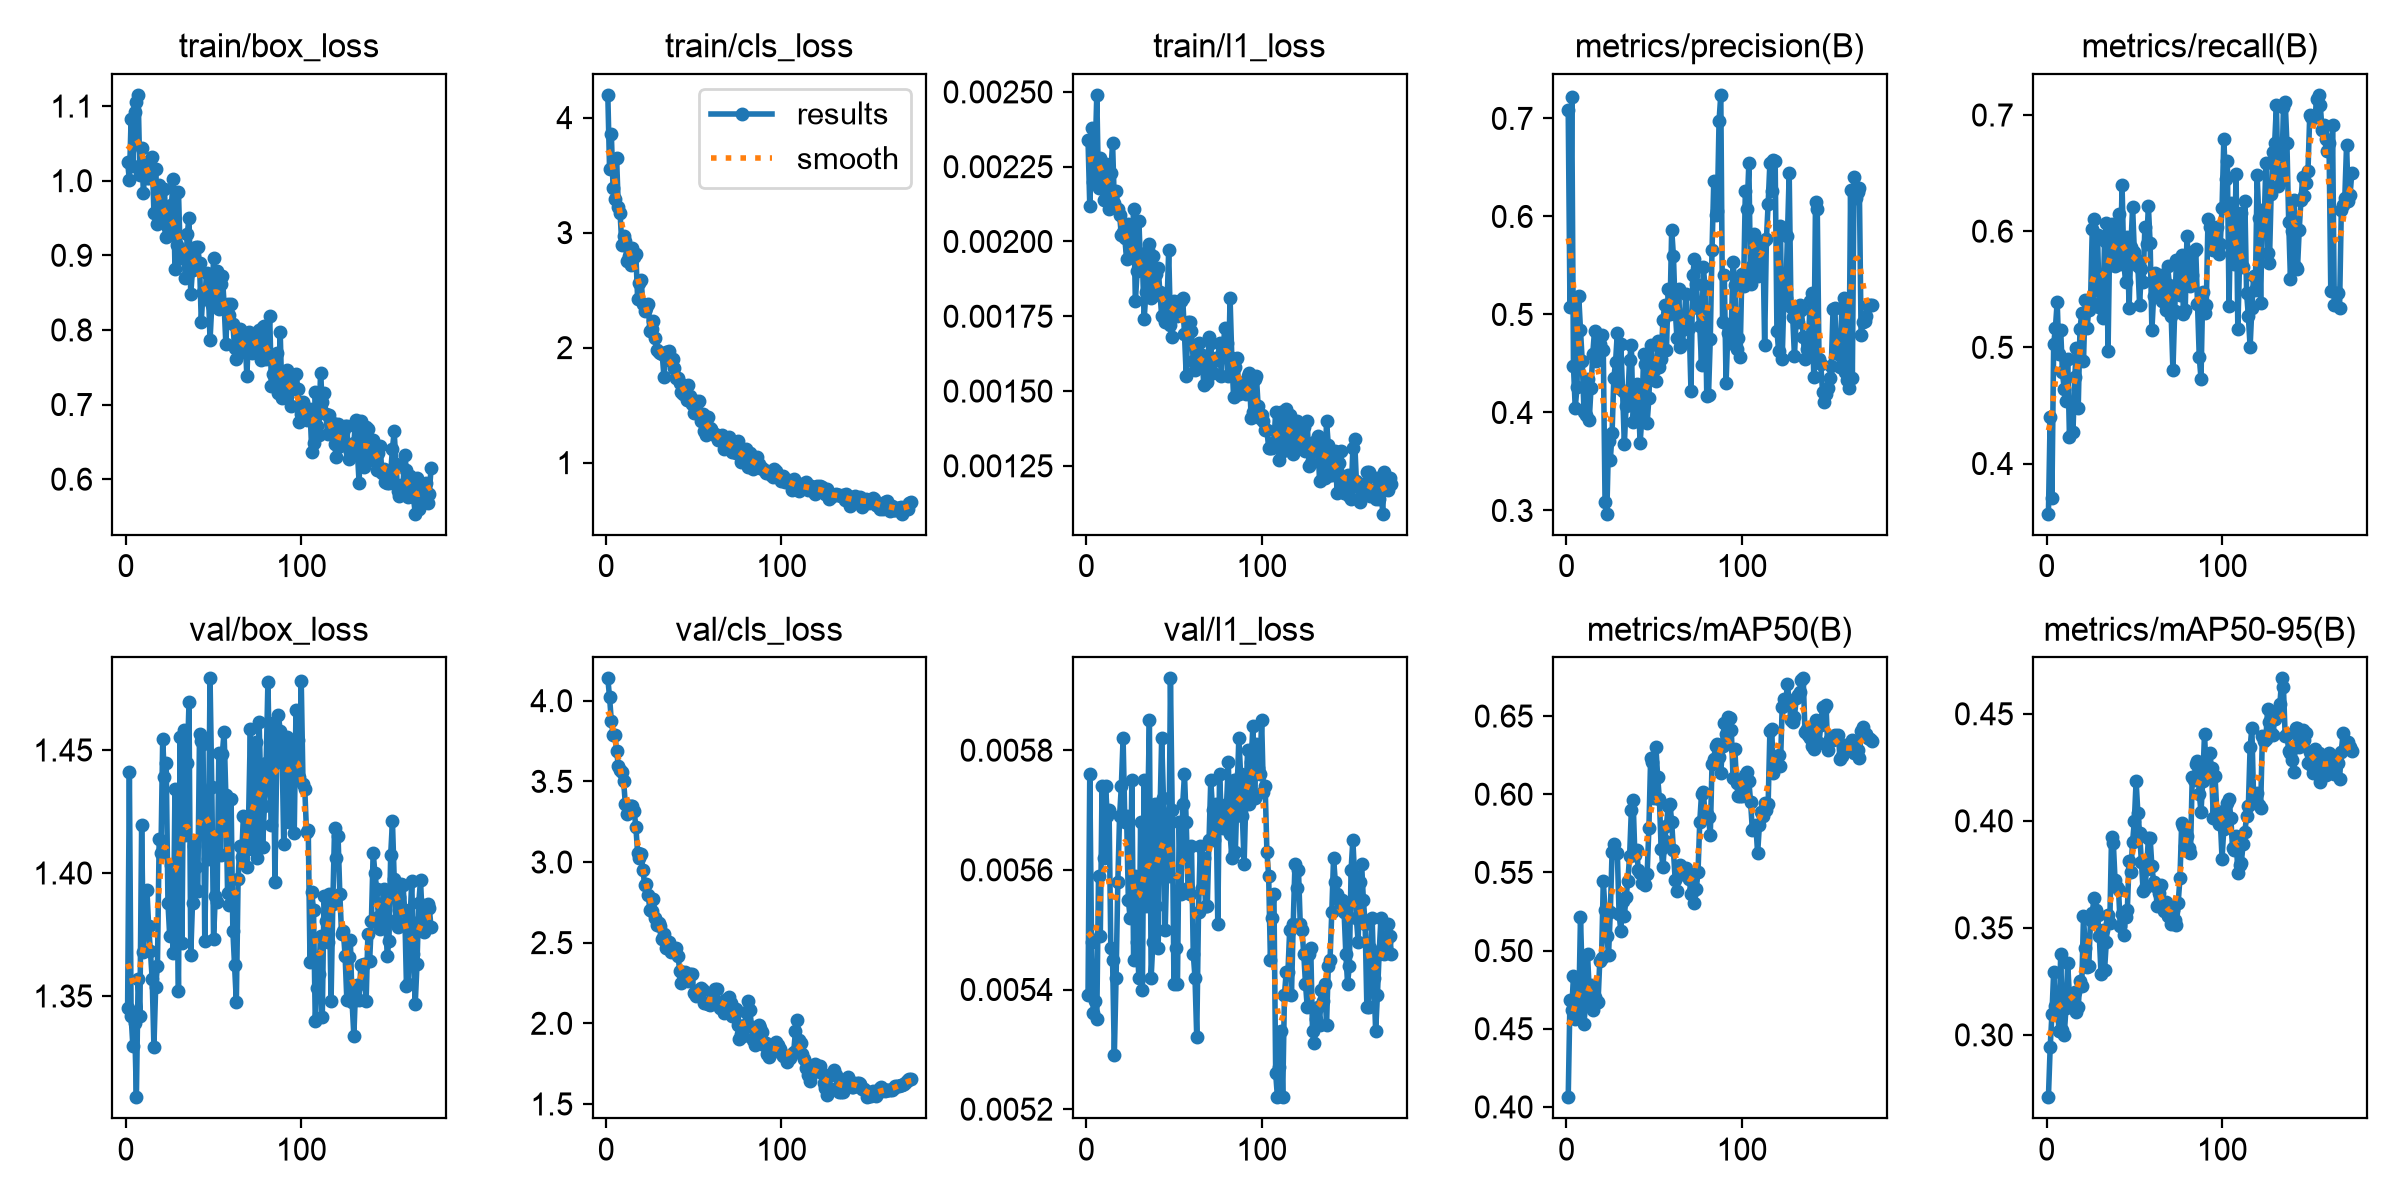
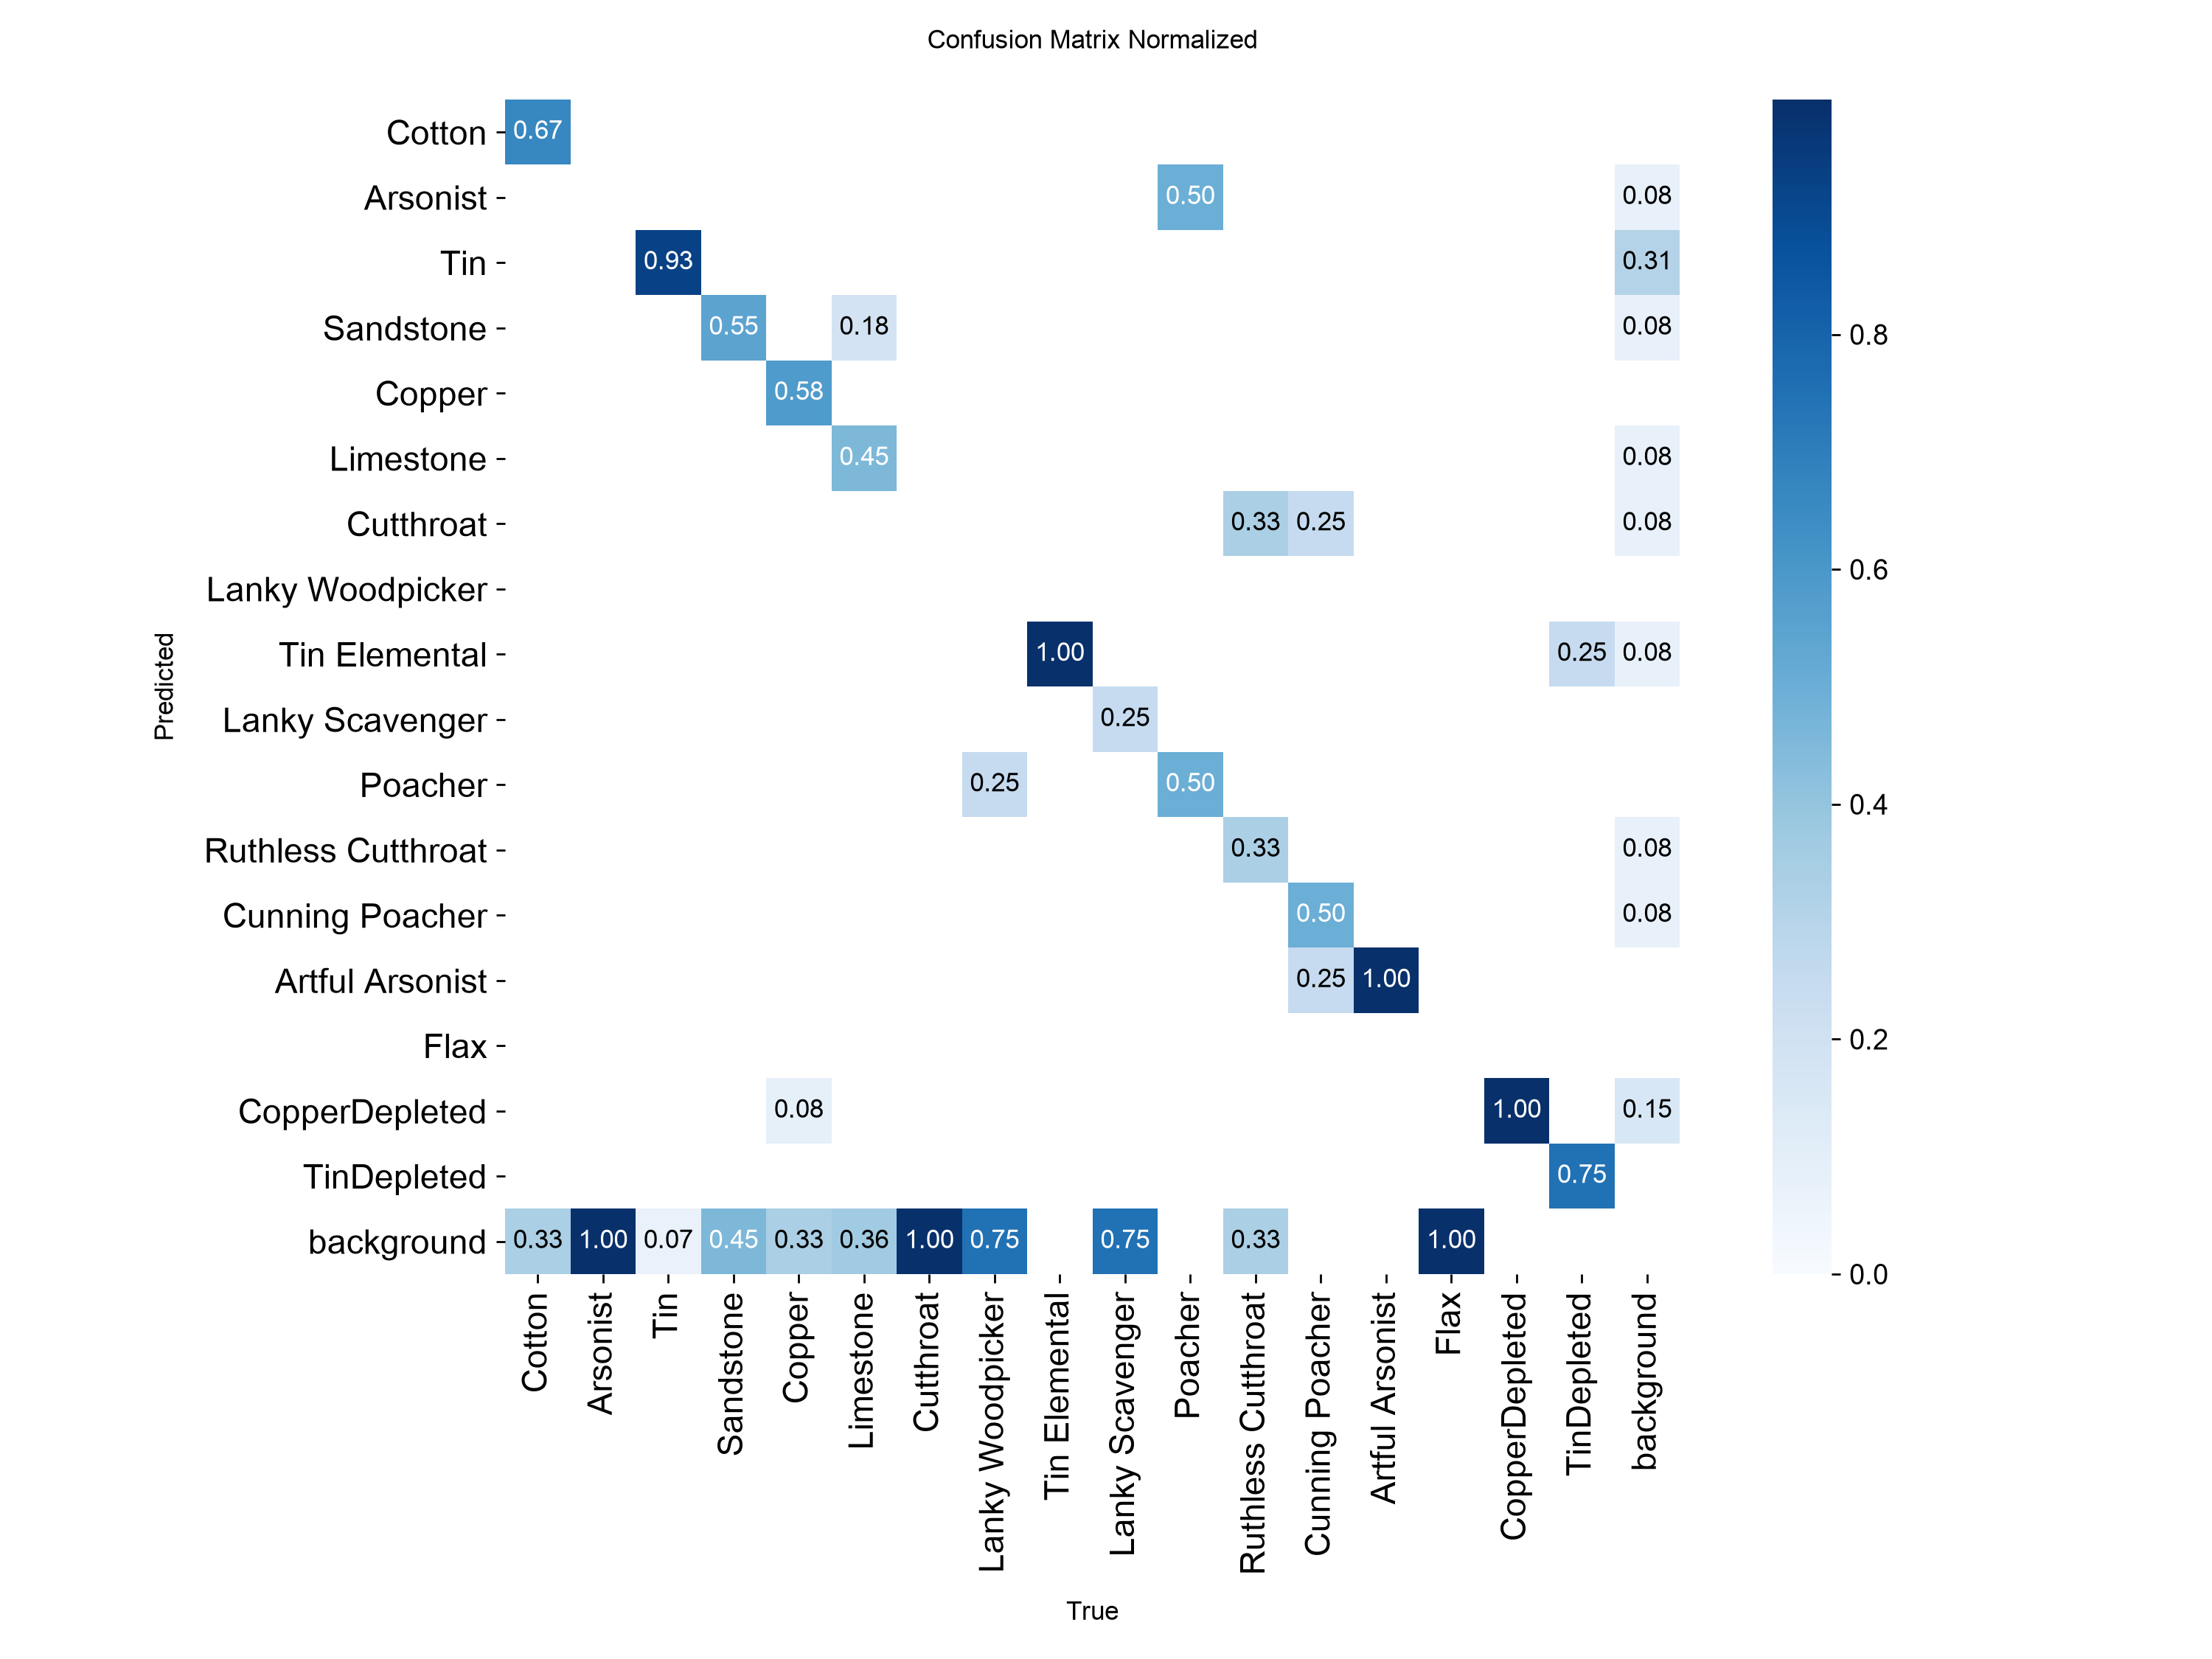
)استخدام أفضل نقاط التفتيش، وفحص التنبؤات على الشاشات غير المرئية، واستعراض كل فئة على حدة. النتيجة العالمية العالية يمكن أن تخفي طبقة نادرة ضعيفة.
(لاي كاي) تستورد (إنكس) وليس الملف التدريبي Export one static NCHW RGB input, batch 1, float32 or float16, and raw one-to-many predictions so LaiCai can apply confidence filtering and NMS. (ONNX)
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")
model.export(
    format="onnx",
    imgsz=960,
    batch=1,
    dynamic=False,
    simplify=True,
    nms=None,
)اختار الدليل نفسه في مكتبة لاي كاي النموذجية. يجب أن يحتوي الدليل على الوصية و الملف الخاص بـ (أن نكس) مسمّى بالنموذج (فايل) يجب أن تبدأ بطاقات الهوية من الدرجة صفر وأن تبقى متقاربة. (ONNX · config.json · modelFile)
game-objects/
├── config.json
└── model.onnx{
"id": "game-objects-v1",
"name": "Game Objects v1",
"type": "yolo",
"modelFile": "model.onnx",
"outputFormat": "raw_yolo_no_objectness",
"id2label": {
"0": "Copper",
"1": "CopperDepleted",
"2": "Wood",
"3": "Monster"
},
"label2id": {
"Copper": 0,
"CopperDepleted": 1,
"Wood": 2,
"Monster": 3
}
}إذا قال (لاي كاي) أنّ الوصية مفقودة أو غير قابلة للقراءة، فقد اخترت ملفّاً لـ(أنكس) أو ملفاً ناقصاً. استورد الدليل المثالي الكامل وتأكد من أن (إيد2لابل) أو (أو سم2د) يعرف كل صف (ONNX · config.json · id2label · label2id)
مفتوحLaiCai Flowأذهب إلى المكتبة النموذجية، واستورد الدليل المعد، وأكّد أن النموذج مقارن قبل استخدامه في الرؤية. كشف (vision.detect)
أنقذ الصور الأصليةYOLOعلامات، قائمة الطبقة، بيانات يامل، قيادة تدريب، وأفضل معا. وهذه الملفات هي مصدر البيانات القابلة لإعادة الاستخدام؛ وملف شركة " أنكس " المصدرة وحدها لا يكفي لإعادة التدريب الموثوق به. (ONNX · data.yaml · best.pt)
لا وضع علامة على الدفعة الجديدة، تصديرها، ودمجها مع نظام البيانات القديم المنقذ. إعادة تصنيف البيانات القديمة فقط عندما تحتاج لتصحيح الشروح القديمة
نعم، ولكن تذييله بعد الفصول الحالية وجني التصدير الجديد باسم الصف. ثم إعادة التدريب على مجموعة البيانات كاملة حتى تظل الفصول القديمة ممثلة.
والولاياتتان متشابهتان بصرياً ولم يتعلم النموذج التمييز. يضاف فصل مستقل من فئة الولايات المستنفدة أو أمثلة مؤكدة ذات حجية صلبة، ثم يعاد تدريب مصفوفة الارتباك واستعراضها.
لا A threshold can trade recall for precision, but it cannot replace missing classes, inconsistent labels, or confusing negative examples.
وتم فحص الأوامر وخيارات التوافق في هذا الدليل مقارنة بالوثائق الرسمية الحالية وعقد لاي كاي النموذجي.
بعد أن يكون النموذج متوافقاً، استخدم الرؤية الكشف عن اختيار طبقة، وعتبة، ومنطقة شاشة، ثم ربط النجاح أو الفشل بالعمل التالي. (vision.detect)