开始之前
当莱彩需要知道目标在画面中的位置时,应选择目标检测。图像分类只能判断整张图片包含什么,不会返回目标框。
这篇教程会带你从原始截图一直做到莱彩可用的 ONNX 模型。示例来自一个小目标游戏数据集,但同一套流程也适用于 App 按钮、商品、图标、工具和其他画面目标。
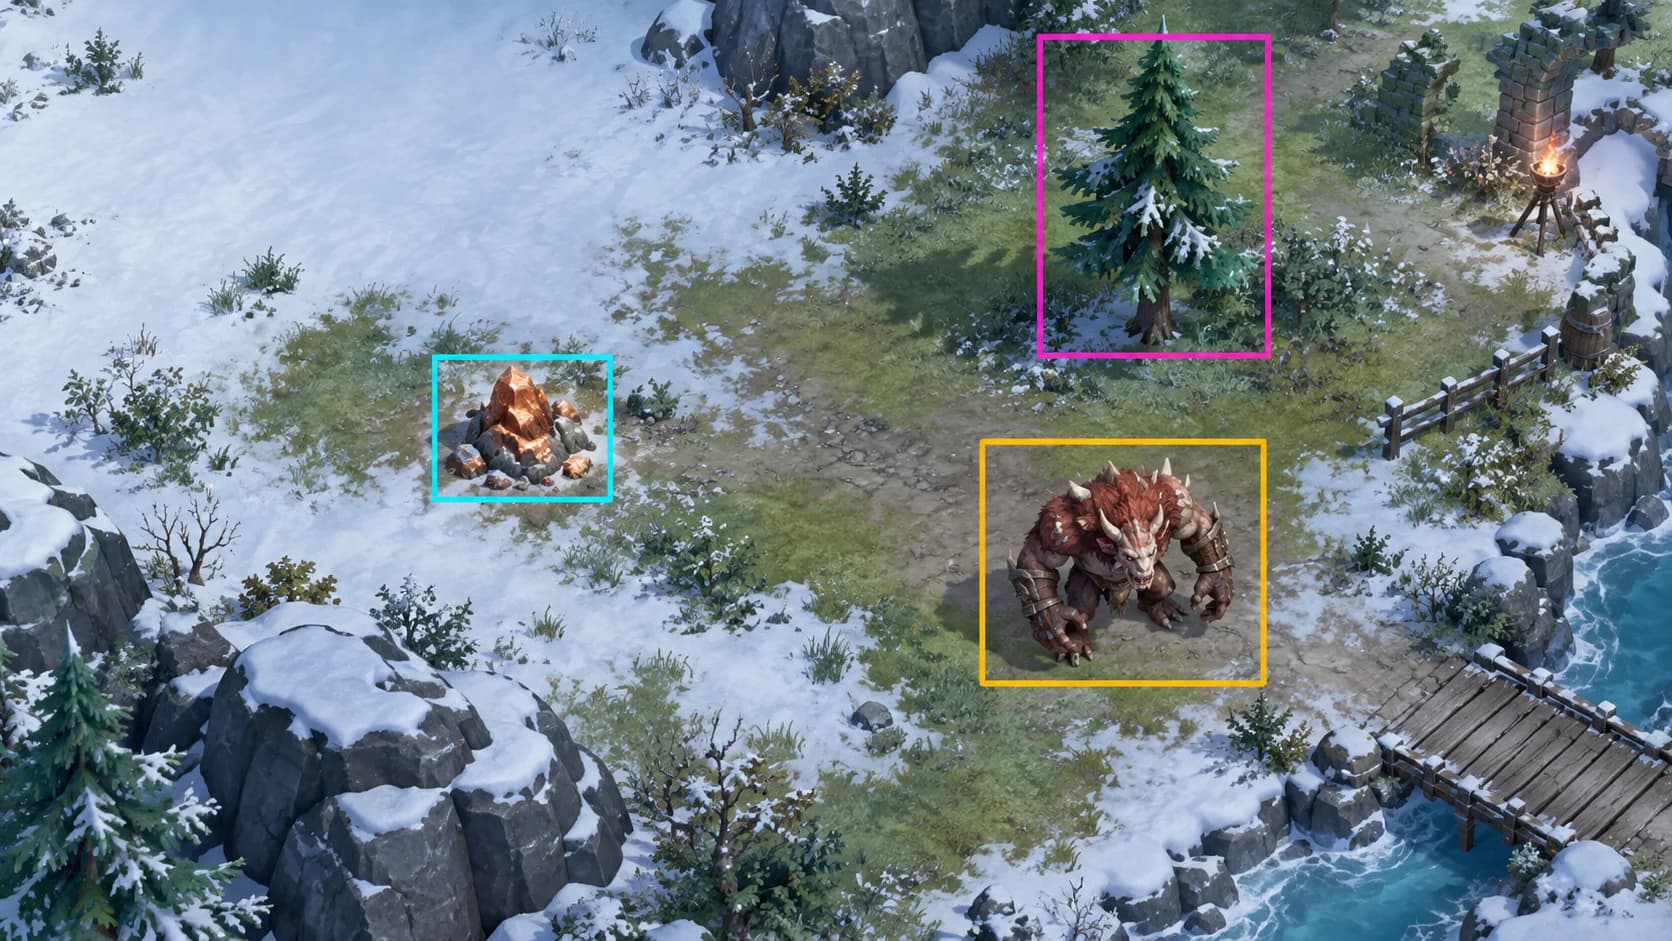
当莱彩需要知道目标在画面中的位置时,应选择目标检测。图像分类只能判断整张图片包含什么,不会返回目标框。
通常可以。只要它们出现在同一款游戏或 App 中,截图比例一致,并且需要在同一个 Flow 里识别,就适合放进一个模型。只有场景完全无关、类别非常多,或某一组目标需要不同输入尺寸和性能目标时,才考虑拆分模型。
使用莱彩实际会看到的设备、分辨率、缩放和画质来采图。画面的多样性,比从视频里连续保存大量几乎相同的帧更重要。
每个类别都应对应 Flow 需要做出的一个视觉判断。名称要短、唯一且保持不变,因为 YOLO 标签、data.yaml、config.json 和 vision.detect 的类别选择都会使用同一顺序。
如果资源被采集后仍然很像可采集状态,就把两种状态都标出来,例如 Copper 和 CopperDepleted。不要指望只调置信度,就能稳定区分两个真实视觉状态。
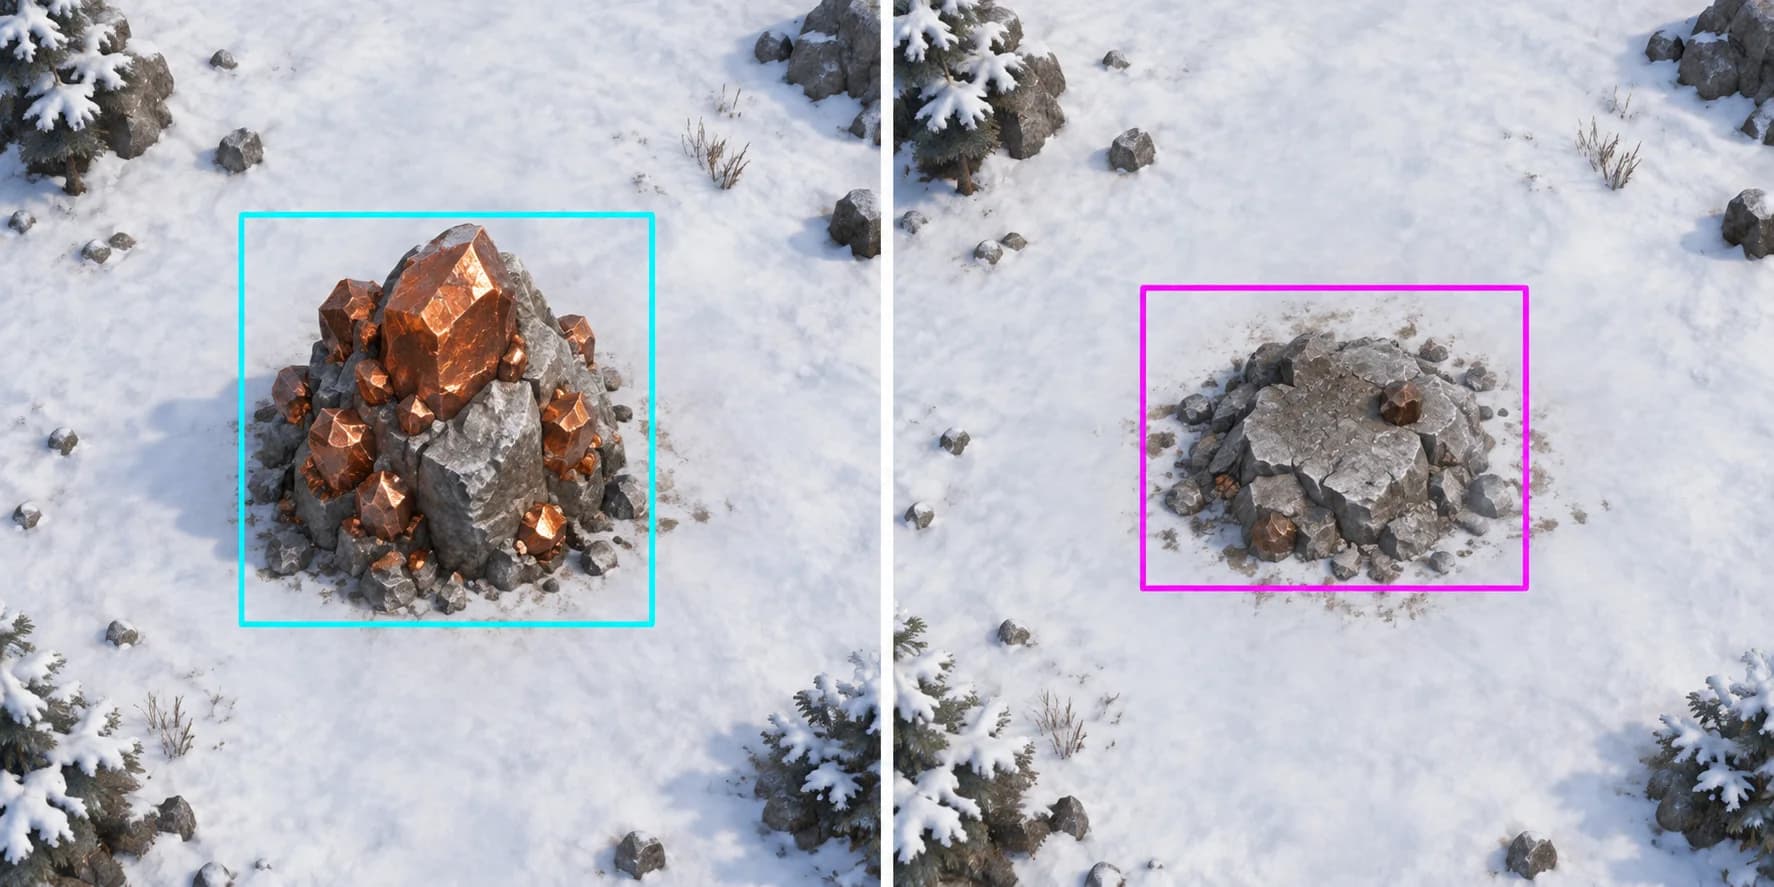
MakeSense.ai 是免费的浏览器标注工具。为莱彩制作模型时,应选择 Object Detection,使用矩形框,并导出 YOLO 标注。
打开 MakeSense.ai 并上传原始图片。原图文件夹要自己保留;导出的标签 ZIP 不能替代原图。
选择 Object Detection,不要选择 Image Recognition。
按固定顺序建立最终类别表,然后给每一个目标实例画矩形框。
导出前检查空图片、漏标、错标和过松的框。
把 Rect annotations 导出为 YOLO 格式的 ZIP 包。
每张图片都要有一个同名的 .txt 标签文件。训练集和验证集应按录屏批次或时间段划分,不要把相邻视频帧随机打散到两边。
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── data.yamlpath: /absolute/path/to/dataset
train: images/train
val: images/val
names:
0: Copper
1: CopperDepleted
2: Wood
3: Monster第一次可以从 80% 训练、20% 验证开始。验证集必须包含训练时真正没有见过的场景。
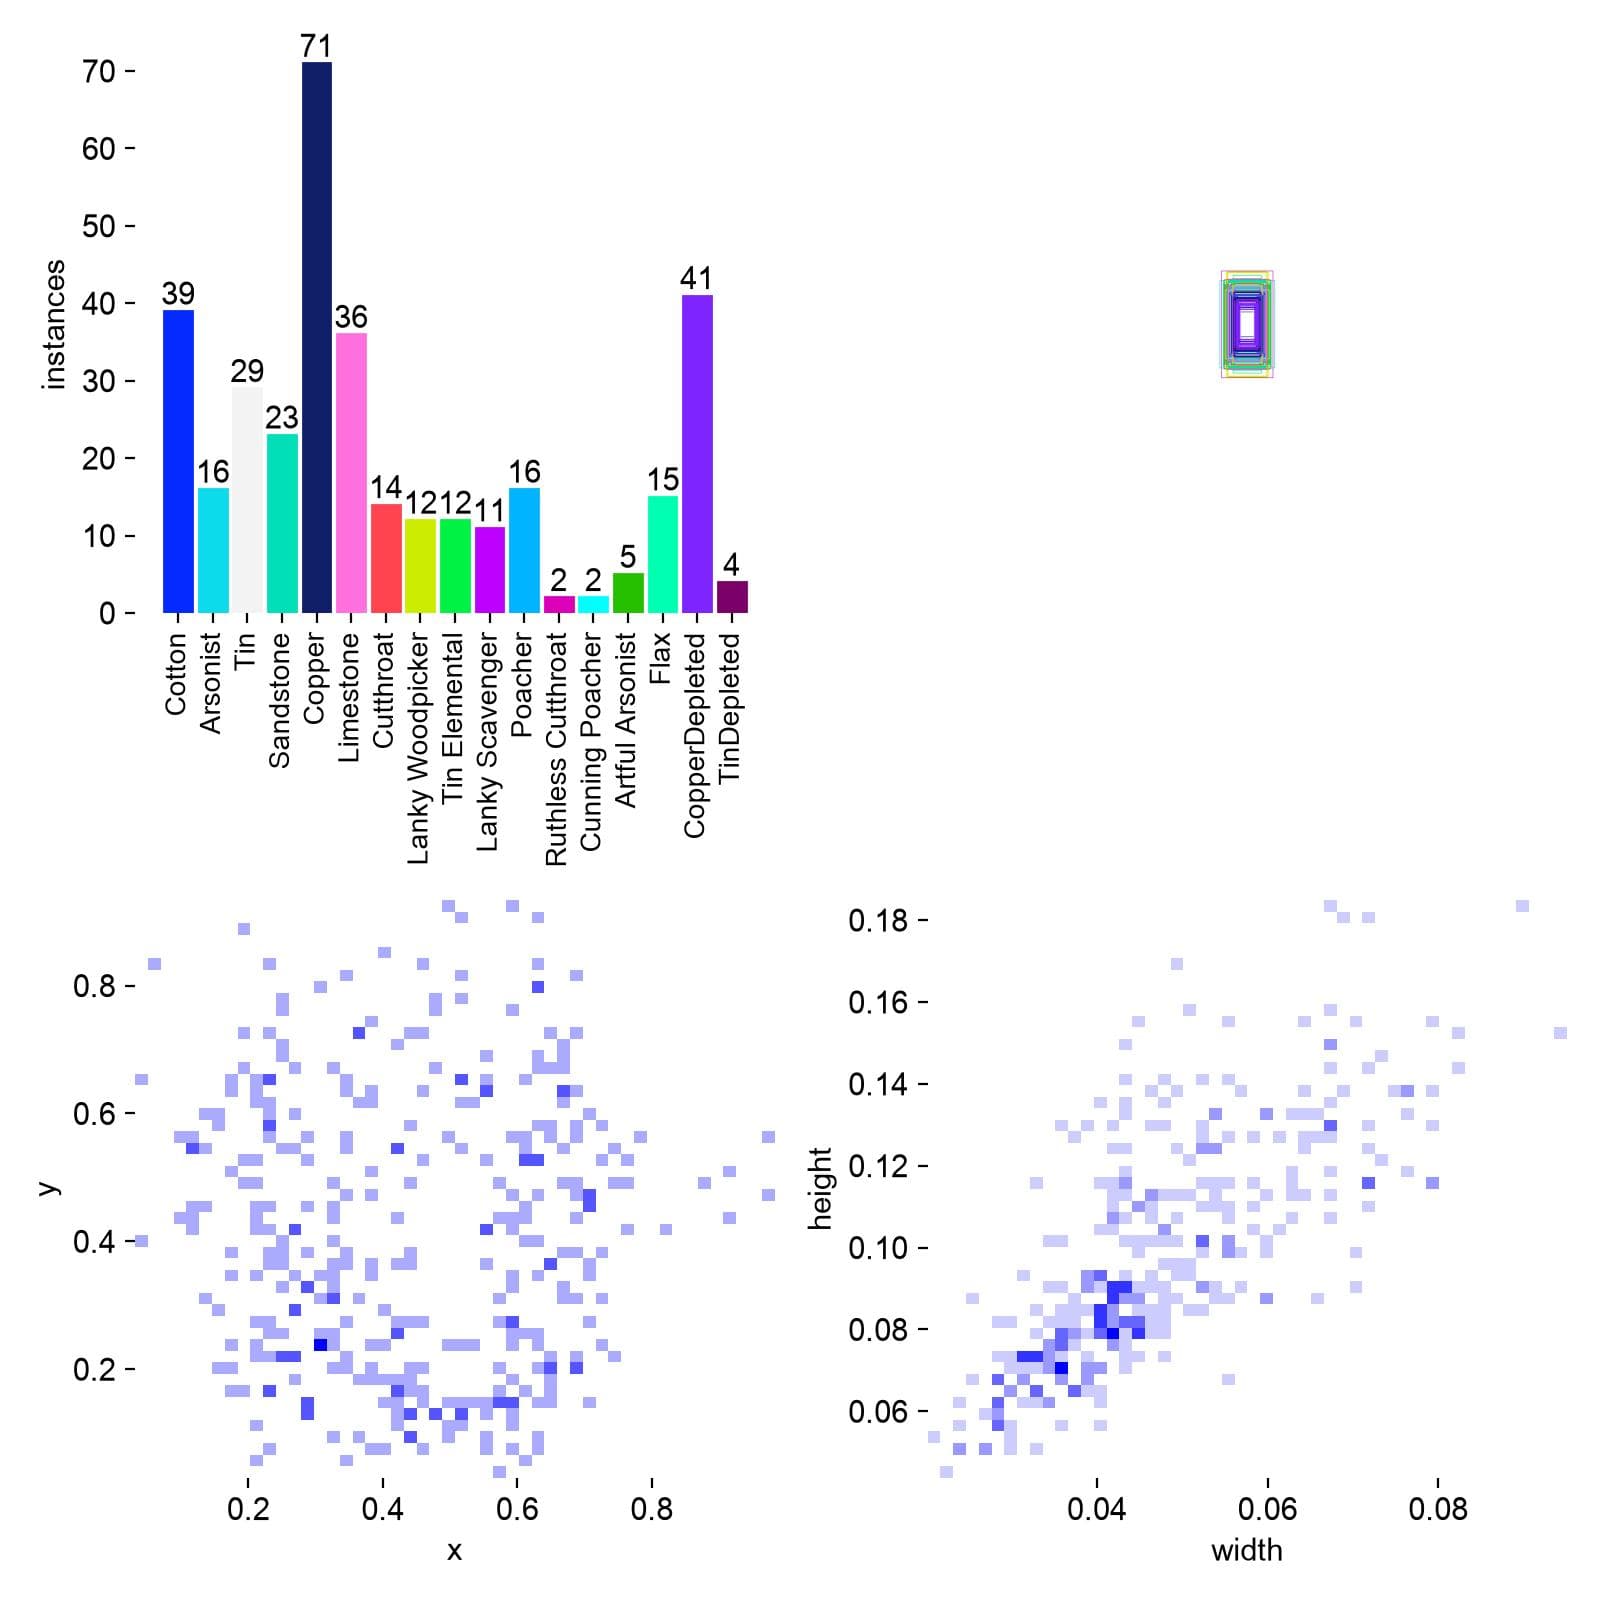
下面使用的是这套流程已经验证过的版本。持续检测建议先从 Nano 模型开始;目标较大时用 640,重要目标很小时可用 960。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install ultralytics==8.4.138 onnx==1.22.0 \
onnxruntime==1.29.0 onnxslim==0.1.96| 参数 | 起步值 | 原因 |
|---|---|---|
model | YOLO26n | 体积小、速度快,适合第一轮验证。 |
imgsz | 960 / 640 | 小目标使用 960;目标较大或更重视速度时使用 640。 |
epochs | 200 | 给足训练上限,同时允许早停提前结束。 |
patience | 40 | 验证指标连续 40 个 epoch 没有提升就停止。 |
batch | 8 | 显存不足时先降到 4 或 2;只有实际测量后才提高。 |
device | mps / 0 / cpu | Apple 芯片使用 mps,NVIDIA 使用 0,任何机器都可以使用 cpu。 |
workers | 4 | 一个较保守的跨平台起点。 |
seed | 42 | 便于重复比较数据集和不同训练版本。 |
close_mosaic | 15 | 最后阶段关闭 mosaic,让模型在更自然的图片上收尾。 |
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="dataset/data.yaml",
    imgsz=960,
    epochs=200,
    patience=40,
    batch=8,
    device="mps",  # NVIDIA: 0 · CPU: "cpu"
    workers=4,
    seed=42,
    close_mosaic=15,
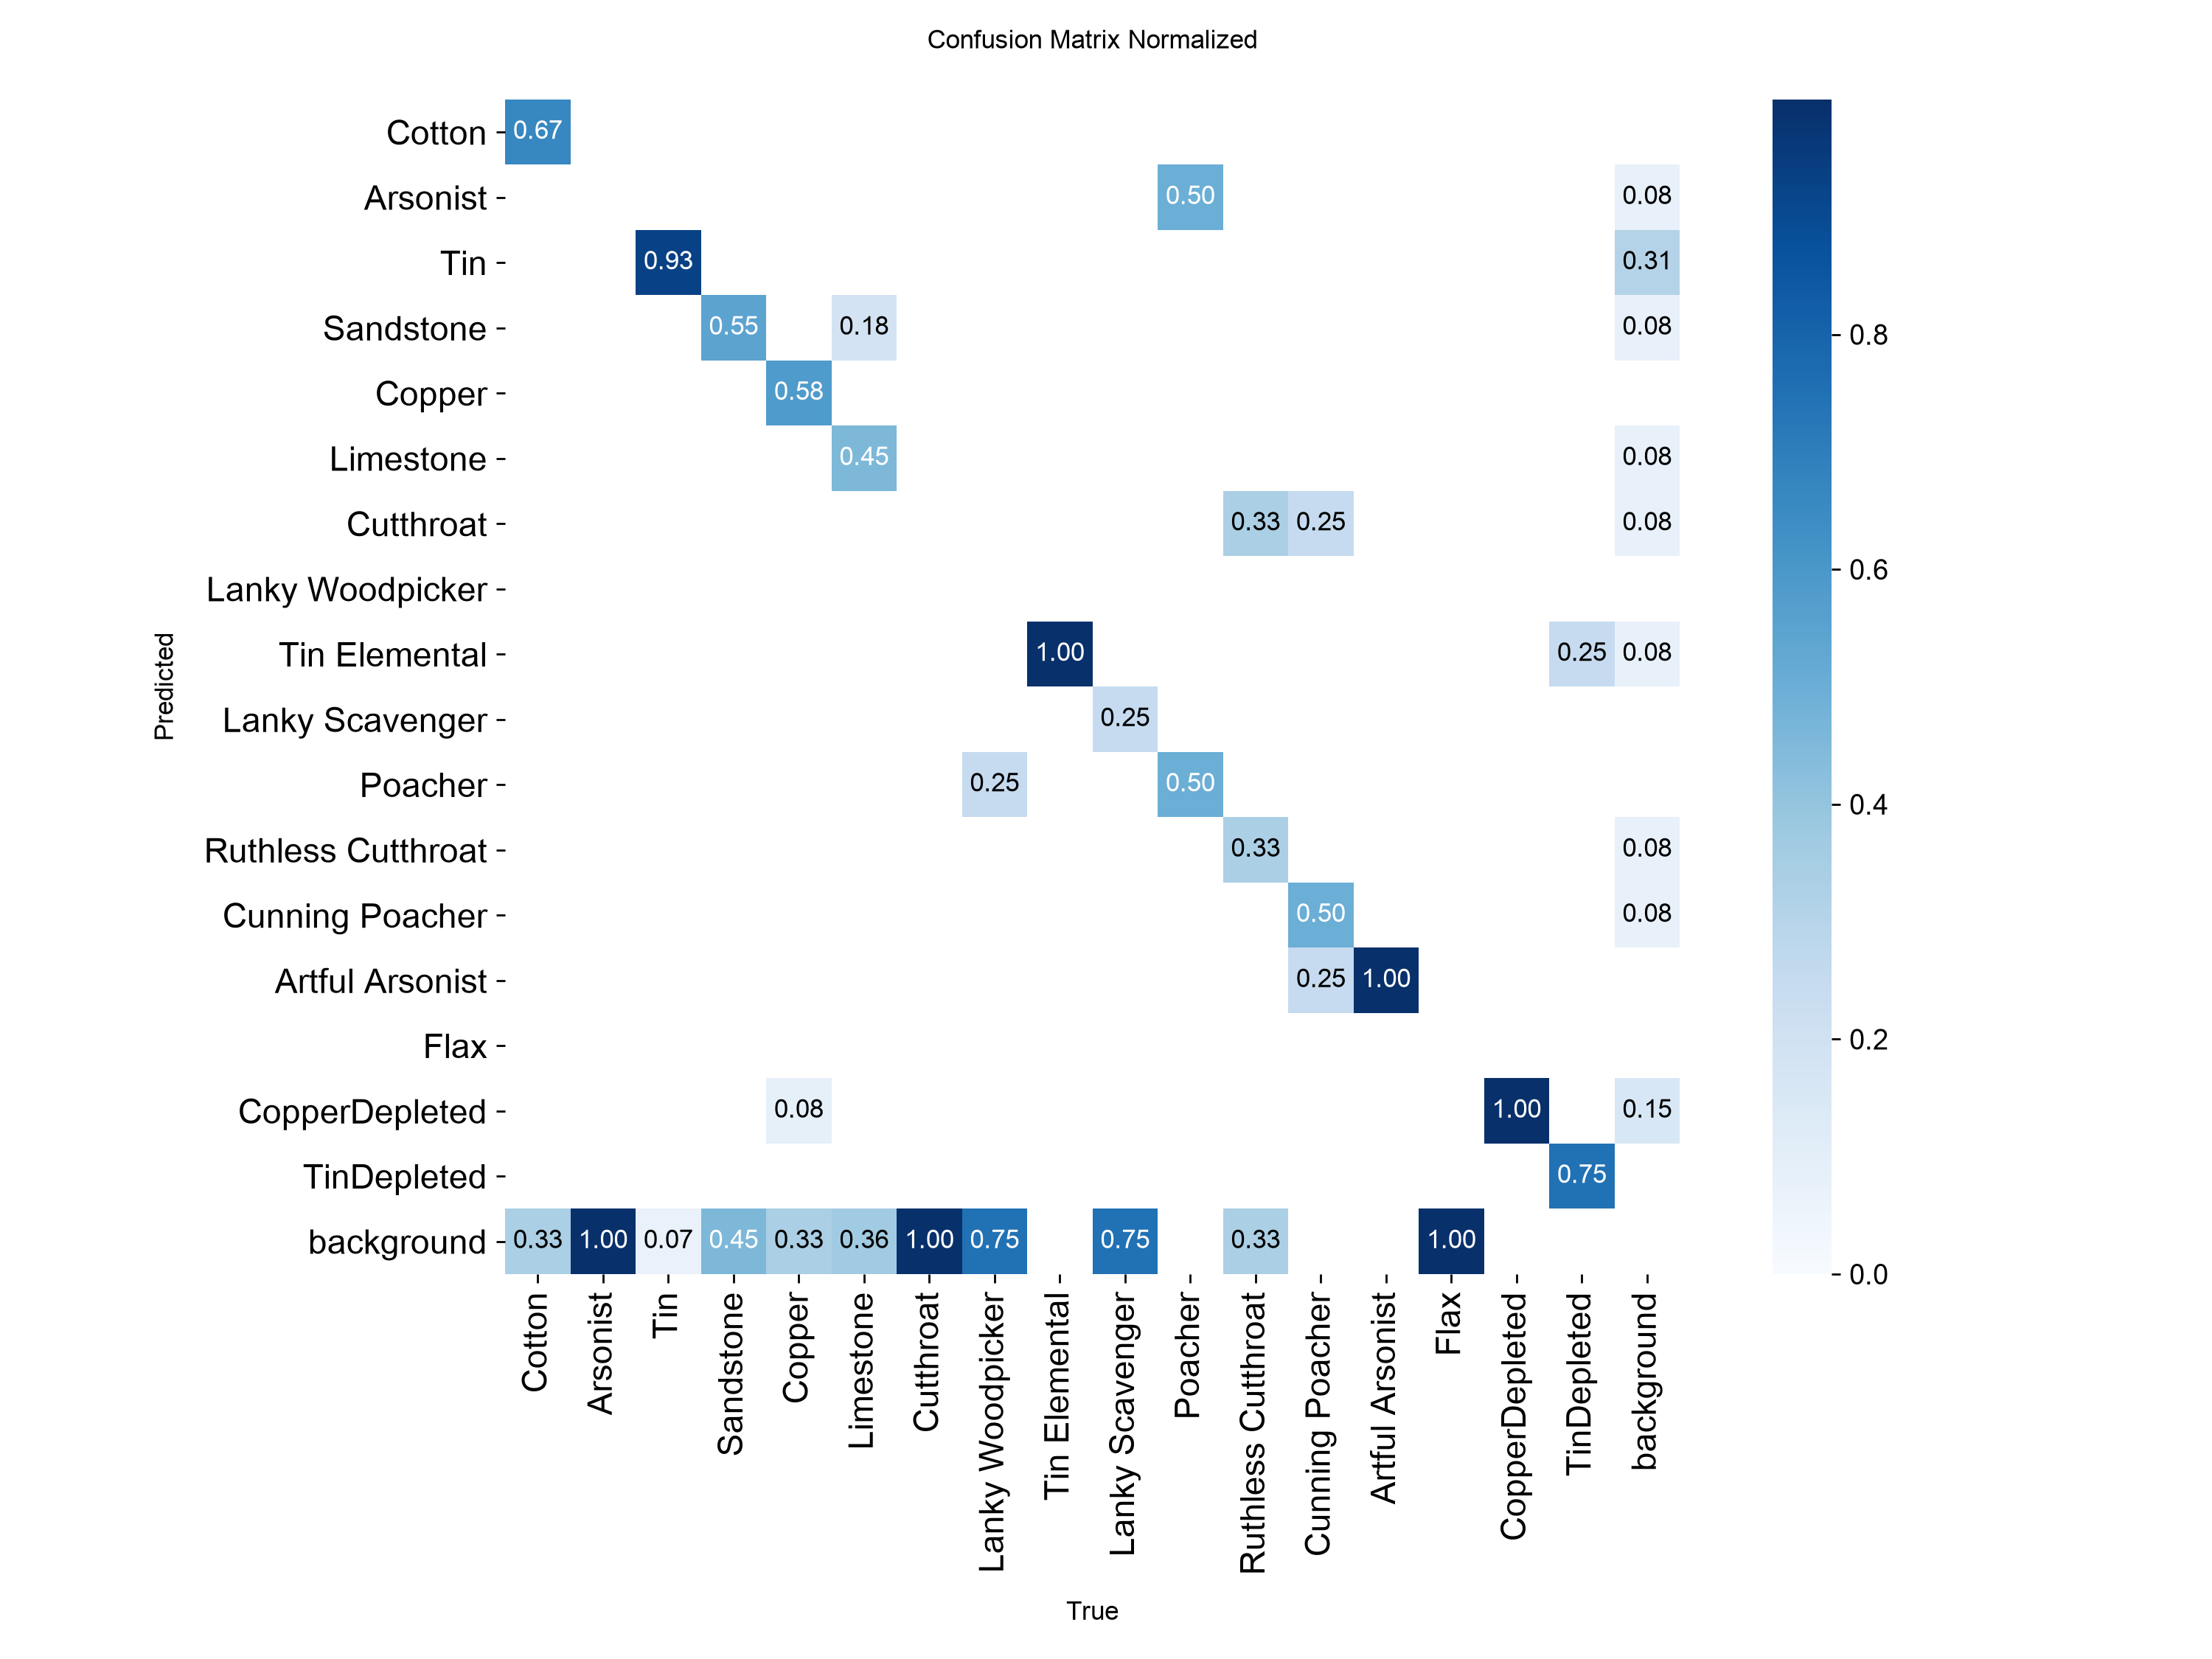
)使用最佳 checkpoint,在未见过的截图上检查预测,并分别查看每一个类别。整体高分可能掩盖某个稀有类别很弱。
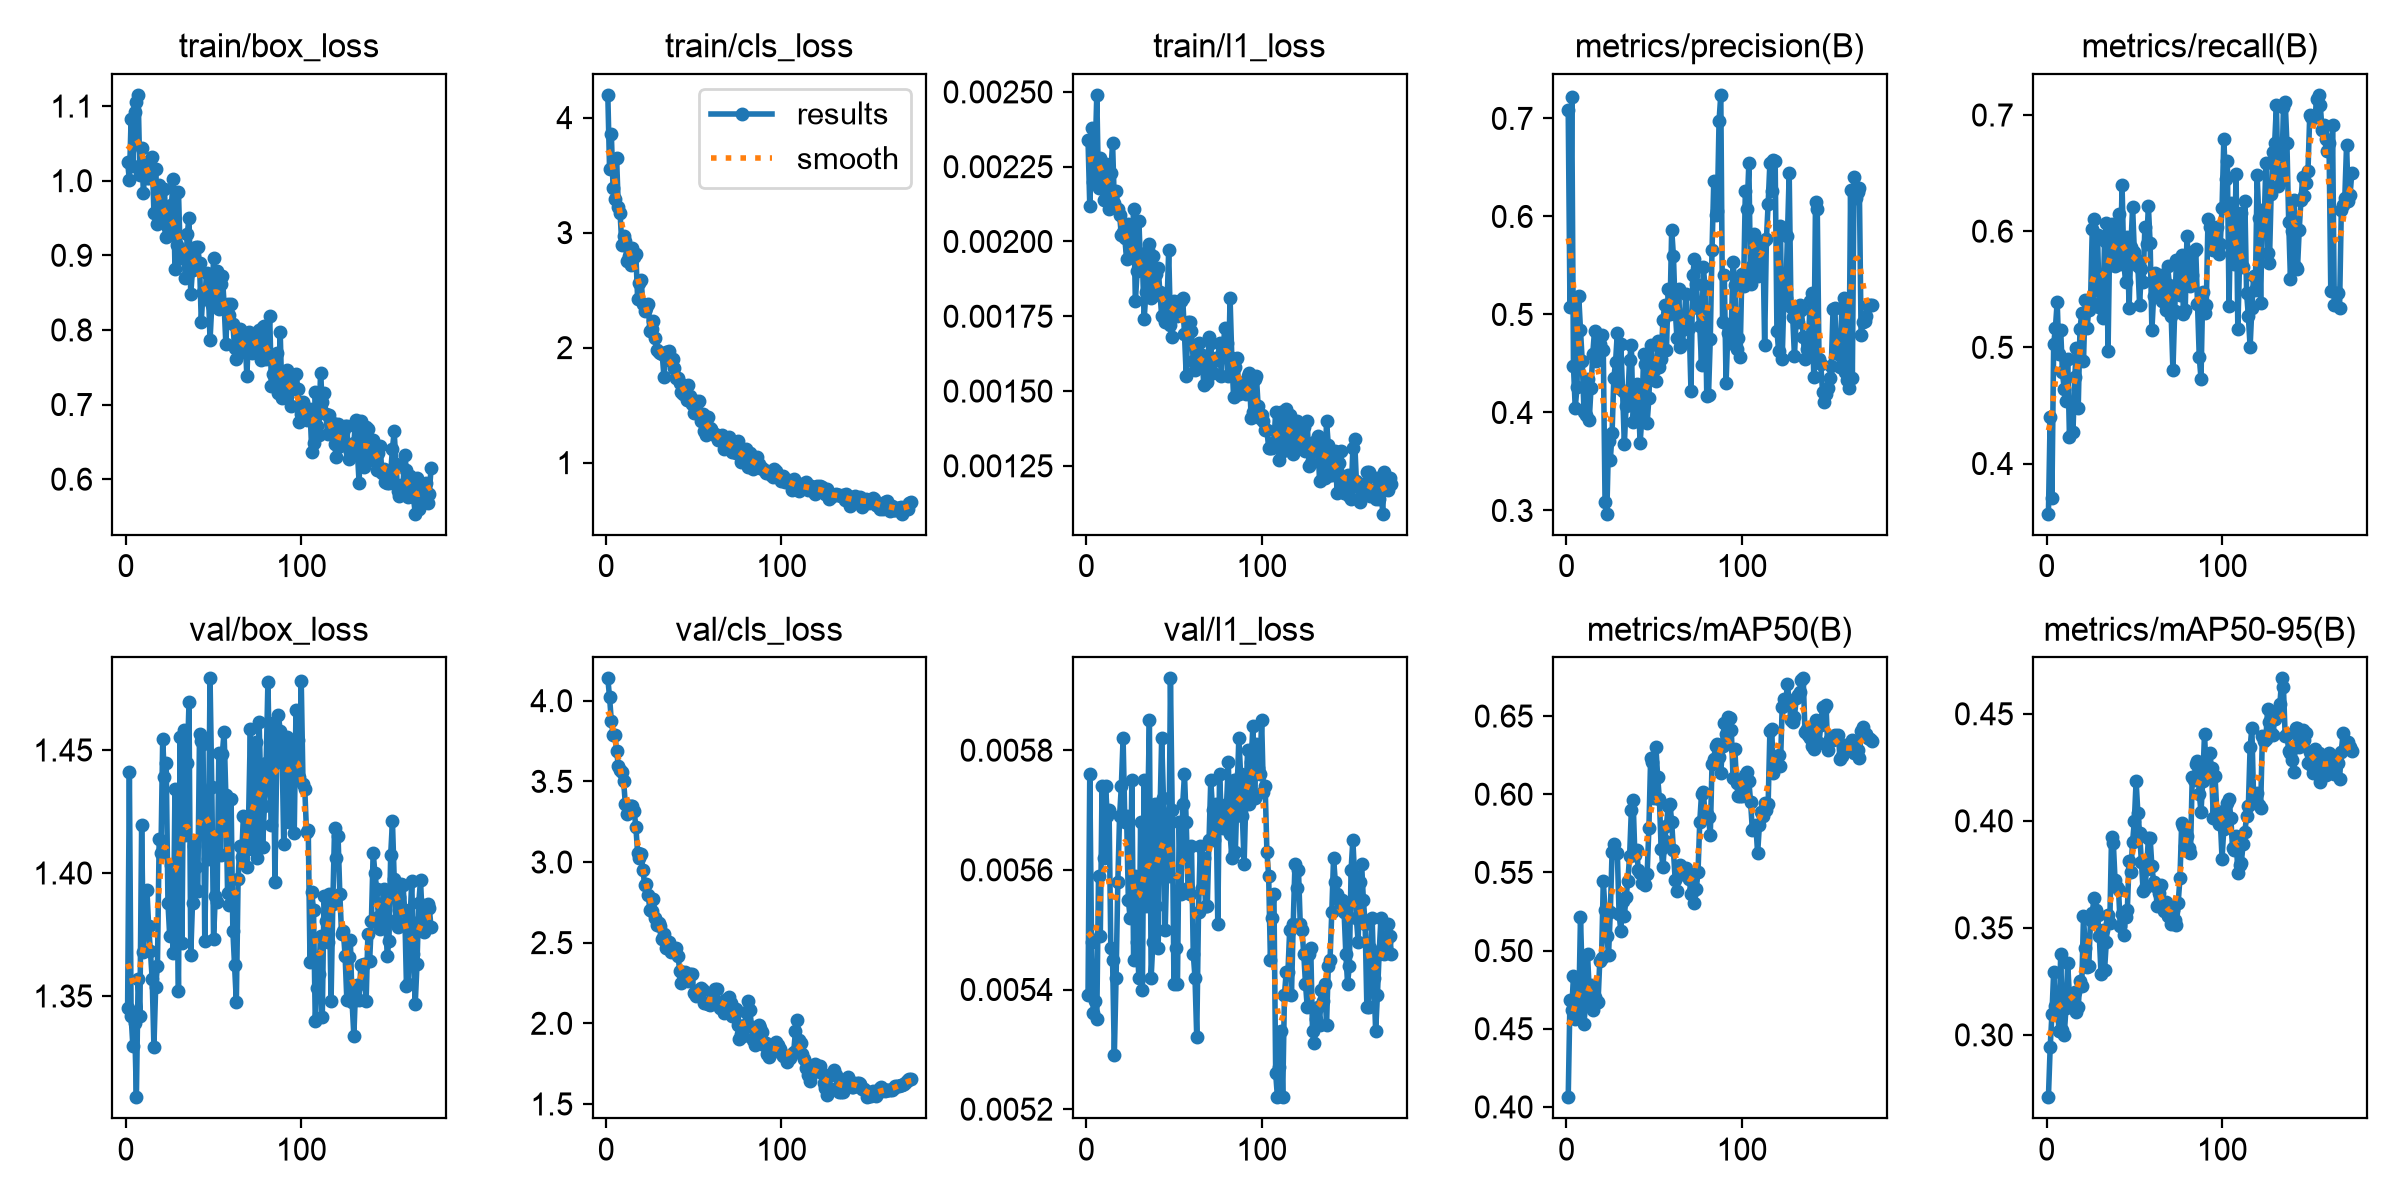
莱彩导入的是 ONNX,不是训练用的 .pt。应导出单个静态 NCHW RGB 输入、batch 1、float32 或 float16,以及原始 one-to-many 预测,让莱彩执行置信度过滤和 NMS。
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")
model.export(
    format="onnx",
    imgsz=960,
    batch=1,
    dynamic=False,
    simplify=True,
    nms=None,
)在莱彩模型库中选择的是整个目录。目录内必须同时有 config.json 和 modelFile 指定的 ONNX 文件;类别 ID 必须从 0 开始连续排列。
game-objects/
├── config.json
└── model.onnx{
"id": "game-objects-v1",
"name": "Game Objects v1",
"type": "yolo",
"modelFile": "model.onnx",
"outputFormat": "raw_yolo_no_objectness",
"id2label": {
"0": "Copper",
"1": "CopperDepleted",
"2": "Wood",
"3": "Monster"
},
"label2id": {
"Copper": 0,
"CopperDepleted": 1,
"Wood": 2,
"Monster": 3
}
}如果莱彩提示 config.json 缺失或无法读取,说明你选择了单独的 ONNX 文件,或目录内容不完整。请导入完整模型目录,并确认 id2label 或 label2id 定义了全部类别。
打开莱彩 Flow,进入模型库,导入准备好的目录;确认模型显示为“兼容”后,再用于 vision.detect。
把原图、YOLO 标签、类别表、data.yaml、训练命令和 best.pt 放在一起保存。它们才是可以持续迭代的数据源;只有导出的 ONNX,无法可靠重训。
不需要。标注新批次、导出后,与保存好的旧数据集离线合并即可。只有需要修正旧标注时,才重新导入旧数据。
可以,但要把新类别追加在旧类别之后,并按类别名称重映射新导出的标签。然后使用完整数据集重训,保证旧类别仍有样本。
两种状态外观接近,而模型没有学会区别。增加独立的已采集状态类别,或加入经过确认的难负样本,然后重新训练并检查混淆矩阵。
不能。阈值只能在召回率和准确率之间取舍,无法替代缺失类别、一致的标注规则或容易混淆的负样本。
本教程中的命令和兼容性选择,已经按照当前官方文档与莱彩真实模型契约核对。
模型兼容后,在 vision.detect 中选择类别、阈值和画面区域,再把成功或失败路径连接到下一步 Flow 动作。