시작하기 전에
LaiCai가 화면에서 물체가 어디에 있는지 찾아야 할 때 객체 탐지를 사용합니다. 이미지 분류는 전체 이미지에 무엇이 포함되어 있는지만 답하고 경계 박스를 반환하지 않습니다.
이 가이드에서는 원본 스크린샷에서 LaiCai 호환 ONNX 모델로 이동합니다. 실제 소규모 게임 데이터 세트를 작업 예제로 사용하지만, 동일한 프로세스는 앱 제어, 제품, 아이콘, 도구 및 기타 표시 가능한 대상에도 적용됩니다.
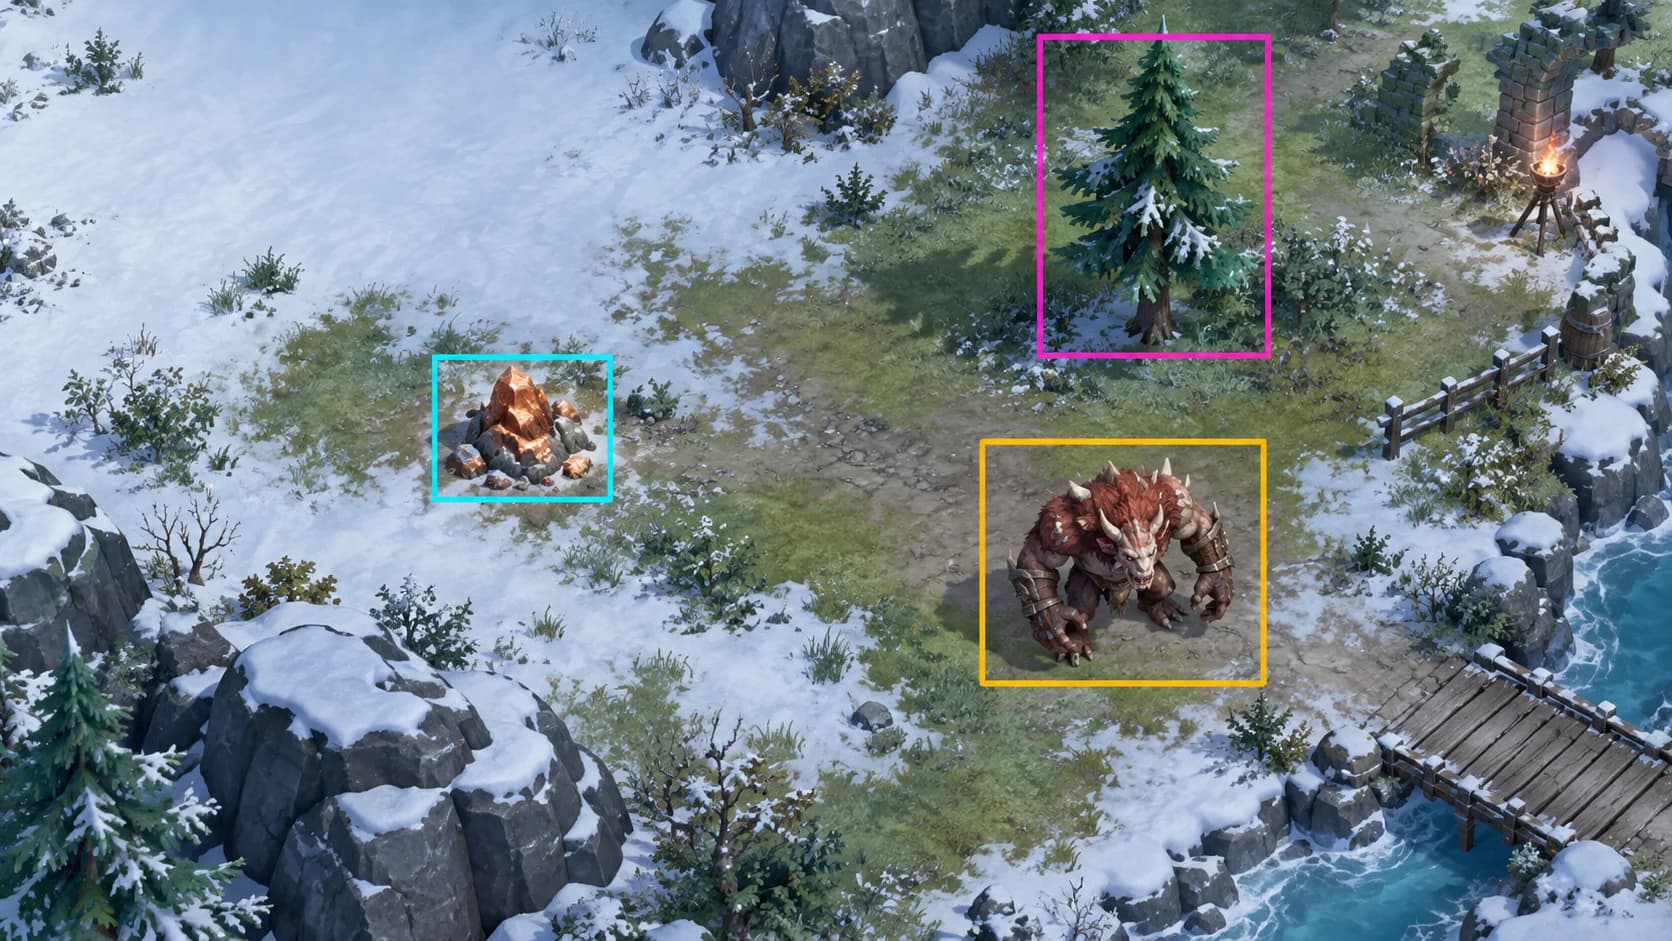
LaiCai가 화면에서 물체가 어디에 있는지 찾아야 할 때 객체 탐지를 사용합니다. 이미지 분류는 전체 이미지에 무엇이 포함되어 있는지만 답하고 경계 박스를 반환하지 않습니다.
일반적으로 같은 게임이나 앱에 나타나고, 동일한 스크린샷 스케일을 사용하고, 동일한 플로우에서 감지되어야 할 때 예입니다. 장면과 관련이 없을 때, 클래스 목록이 매우 커질 때, 또는 한 그룹이 다른 입력 크기나 성능 목표를 필요로 할 때에만 별도의 모델을 사용합니다.
LaiCai가 볼 수 있는 정확한 장치, 해상도, 줌 수준 및 시각적 품질의 프레임들을 수집하세요. 연속적으로 거의 동일한 비디오 프레임을 저장하는 것보다 다양성이 더 중요합니다.
클래스는 Flow가 내려야 할 한 가지 시각적 결정을 나타내야 합니다. 동일한 순서가 사용되기 때문에 이름은 짧고 고유하며 안정적이어야 합니다.YOLO레이블, data.yaml, config.json, 그리고 vision.detect 클래스 선택기.
수집된 리소스가 여전히 사용 가능한 리소스와 유사하다면, 예를 들어 Copper와 CopperDepleted이라는 두 상태를 모두 레이블링하십시오. 단독으로 신뢰 수준만으로는 두 가지 실제 시각적 상태를 확실하게 구분할 수 있다고 기대하지 마십시오.
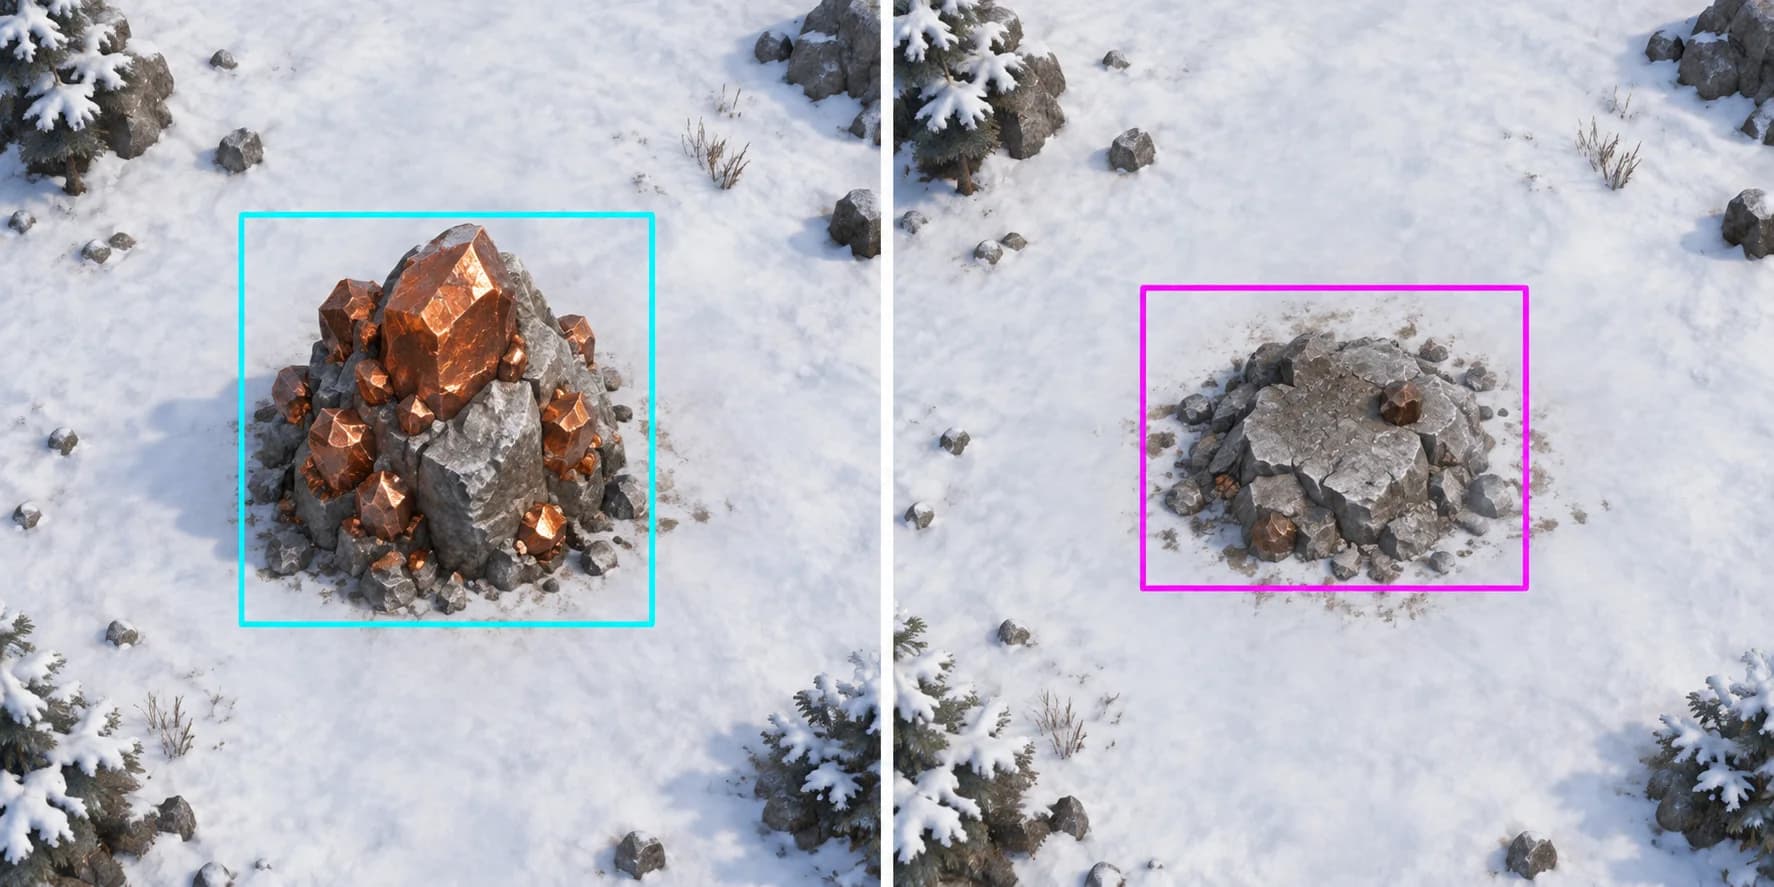
MakeSense.ai는 무료 브라우저 기반 레이블링 도구입니다. LaiCai 모델의 경우 객체 검출을 선택하고 직사각형 상자를 사용하고 내보냅니다.YOLO주석. (Object Detection)
MakeSense.ai를 열고 소스 이미지를 업로드하세요. 원본 이미지 폴더를 그대로 두세요. 내보낸 레이블 ZIP 파일은 이를 대체하지 않습니다.
이미지 인식 대신 객체 검출을 선택하세요. (Object Detection · Image Recognition)
고정된 순서로 최종 클래스 목록을 생성한 다음 각 대상 인스턴스 주위에 직사각형을 그립니다.
내보내기 전에 빈 이미지, 놓친 물체, 잘못된 클래스, 그리고 느슨한 상자를 검토하세요.
Rect 주석을 ZIP 패키지로 내보내기YOLO형식. (Rect annotations)
각 이미지를 동일한 이름의 .txt 레이블 파일과 짝을 지어라. 트레이인과 검증에 인접한 비디오 프레임들을 무작위로 분산시키지 말고, 레코딩 세션이나 시간 범위로 나누어라.
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── data.yamlpath: /absolute/path/to/dataset
train: images/train
val: images/val
names:
0: Copper
1: CopperDepleted
2: Wood
3: Monster실용적인 시작 분할은 80% 훈련과 20% 검증입니다. 검증 세트는 진정으로 본 적이 없는 장면을 포함해야 합니다.
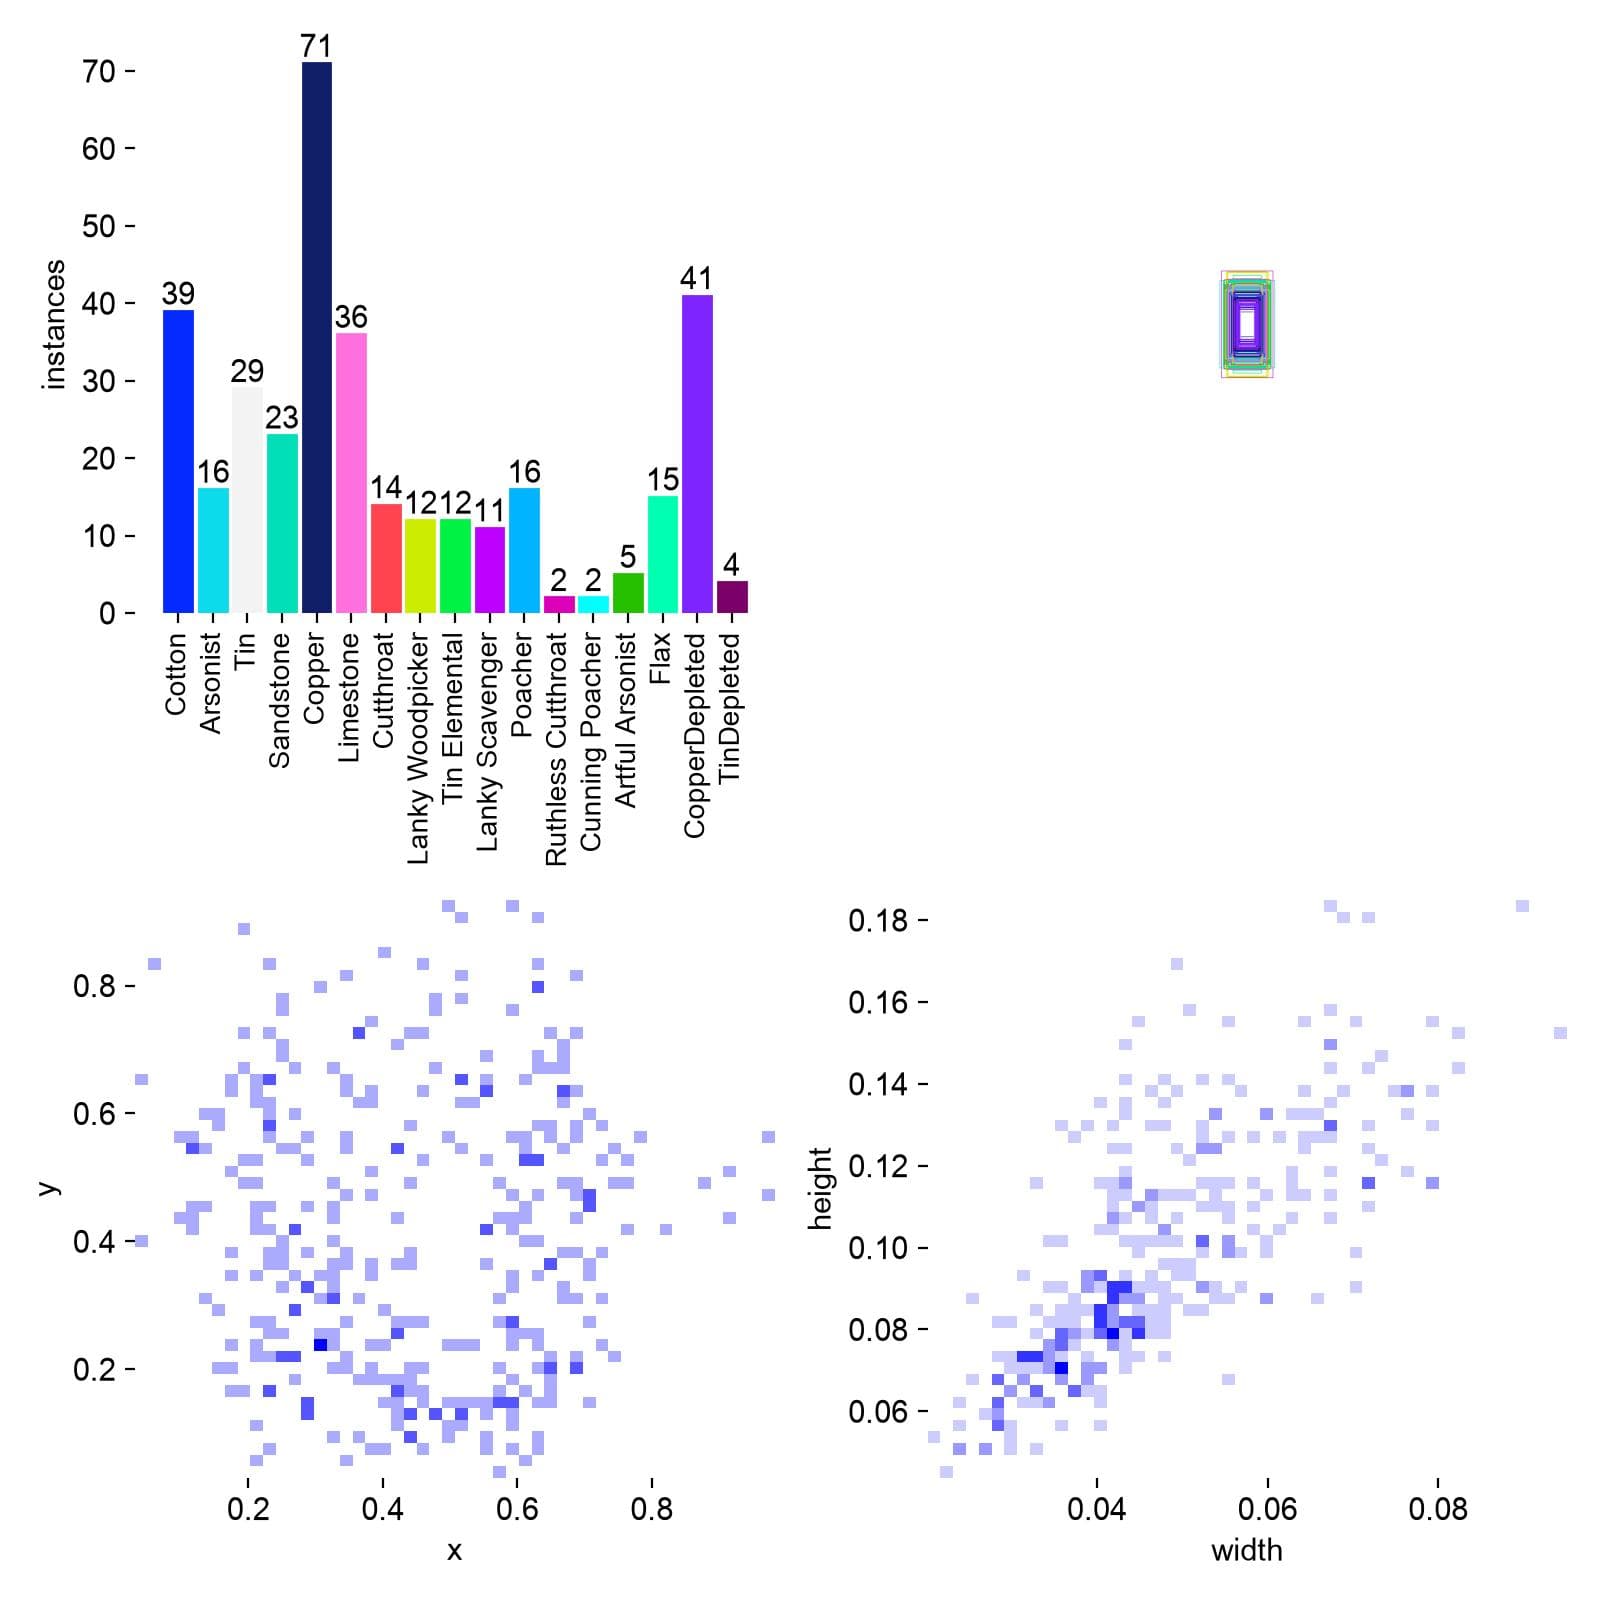
아래 예시는 이 워크플로로 검증된 버전을 사용합니다. 나노 모델은 연속적인 검사에 가장 안전한 시작점입니다. 큰 물체는 640px, 중요한 표적이 작을 때는 960px를 사용합니다.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install ultralytics==8.4.138 onnx==1.22.0 \
onnxruntime==1.29.0 onnxslim==0.1.96| 매개 변수 | 시작 가치 | 왜 |
|---|---|---|
model | YOLO26n | 첫 번째 반복하기에 충분히 작고 빠릅니다. |
imgsz | 960 / 640 | 작은 목표물을 위해 960을 사용하세요; 목표물이 더 크고 속도가 더 중요한 경우 640을 사용하세요. |
epochs | 200 | 자주 멈출 수 있는 것이 더 빨리 끝날 수 있도록 관대한 상한선을 설정합니다. |
patience | 40 | 40개의 에포크 동안 검증이 개선되지 않으면 중지됩니다. |
batch | 8 | 메모리가 부족하면 4 또는 2로 줄이고, 측정한 후에만 늘리세요. |
device | mps / 0 / cpu | 애플 실리콘은 mps를 사용하며, 엔비디아는 0을 사용하고, 어떤 기계든 cpu를 사용할 수 있다. |
workers | 4 | 보수적인 크로스 플랫폼 시작점. |
seed | 42 | 데이터셋과 훈련 비교를 복제하기 더 쉽게 만듭니다. |
close_mosaic | 15 | 마지막 끝에 있는 모자이크를 비활성화하여 최종 에포크가 더 자연스러운 이미지를 볼 수 있도록 합니다. |
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="dataset/data.yaml",
    imgsz=960,
    epochs=200,
    patience=40,
    batch=8,
    device="mps",  # NVIDIA: 0 · CPU: "cpu"
    workers=4,
    seed=42,
    close_mosaic=15,
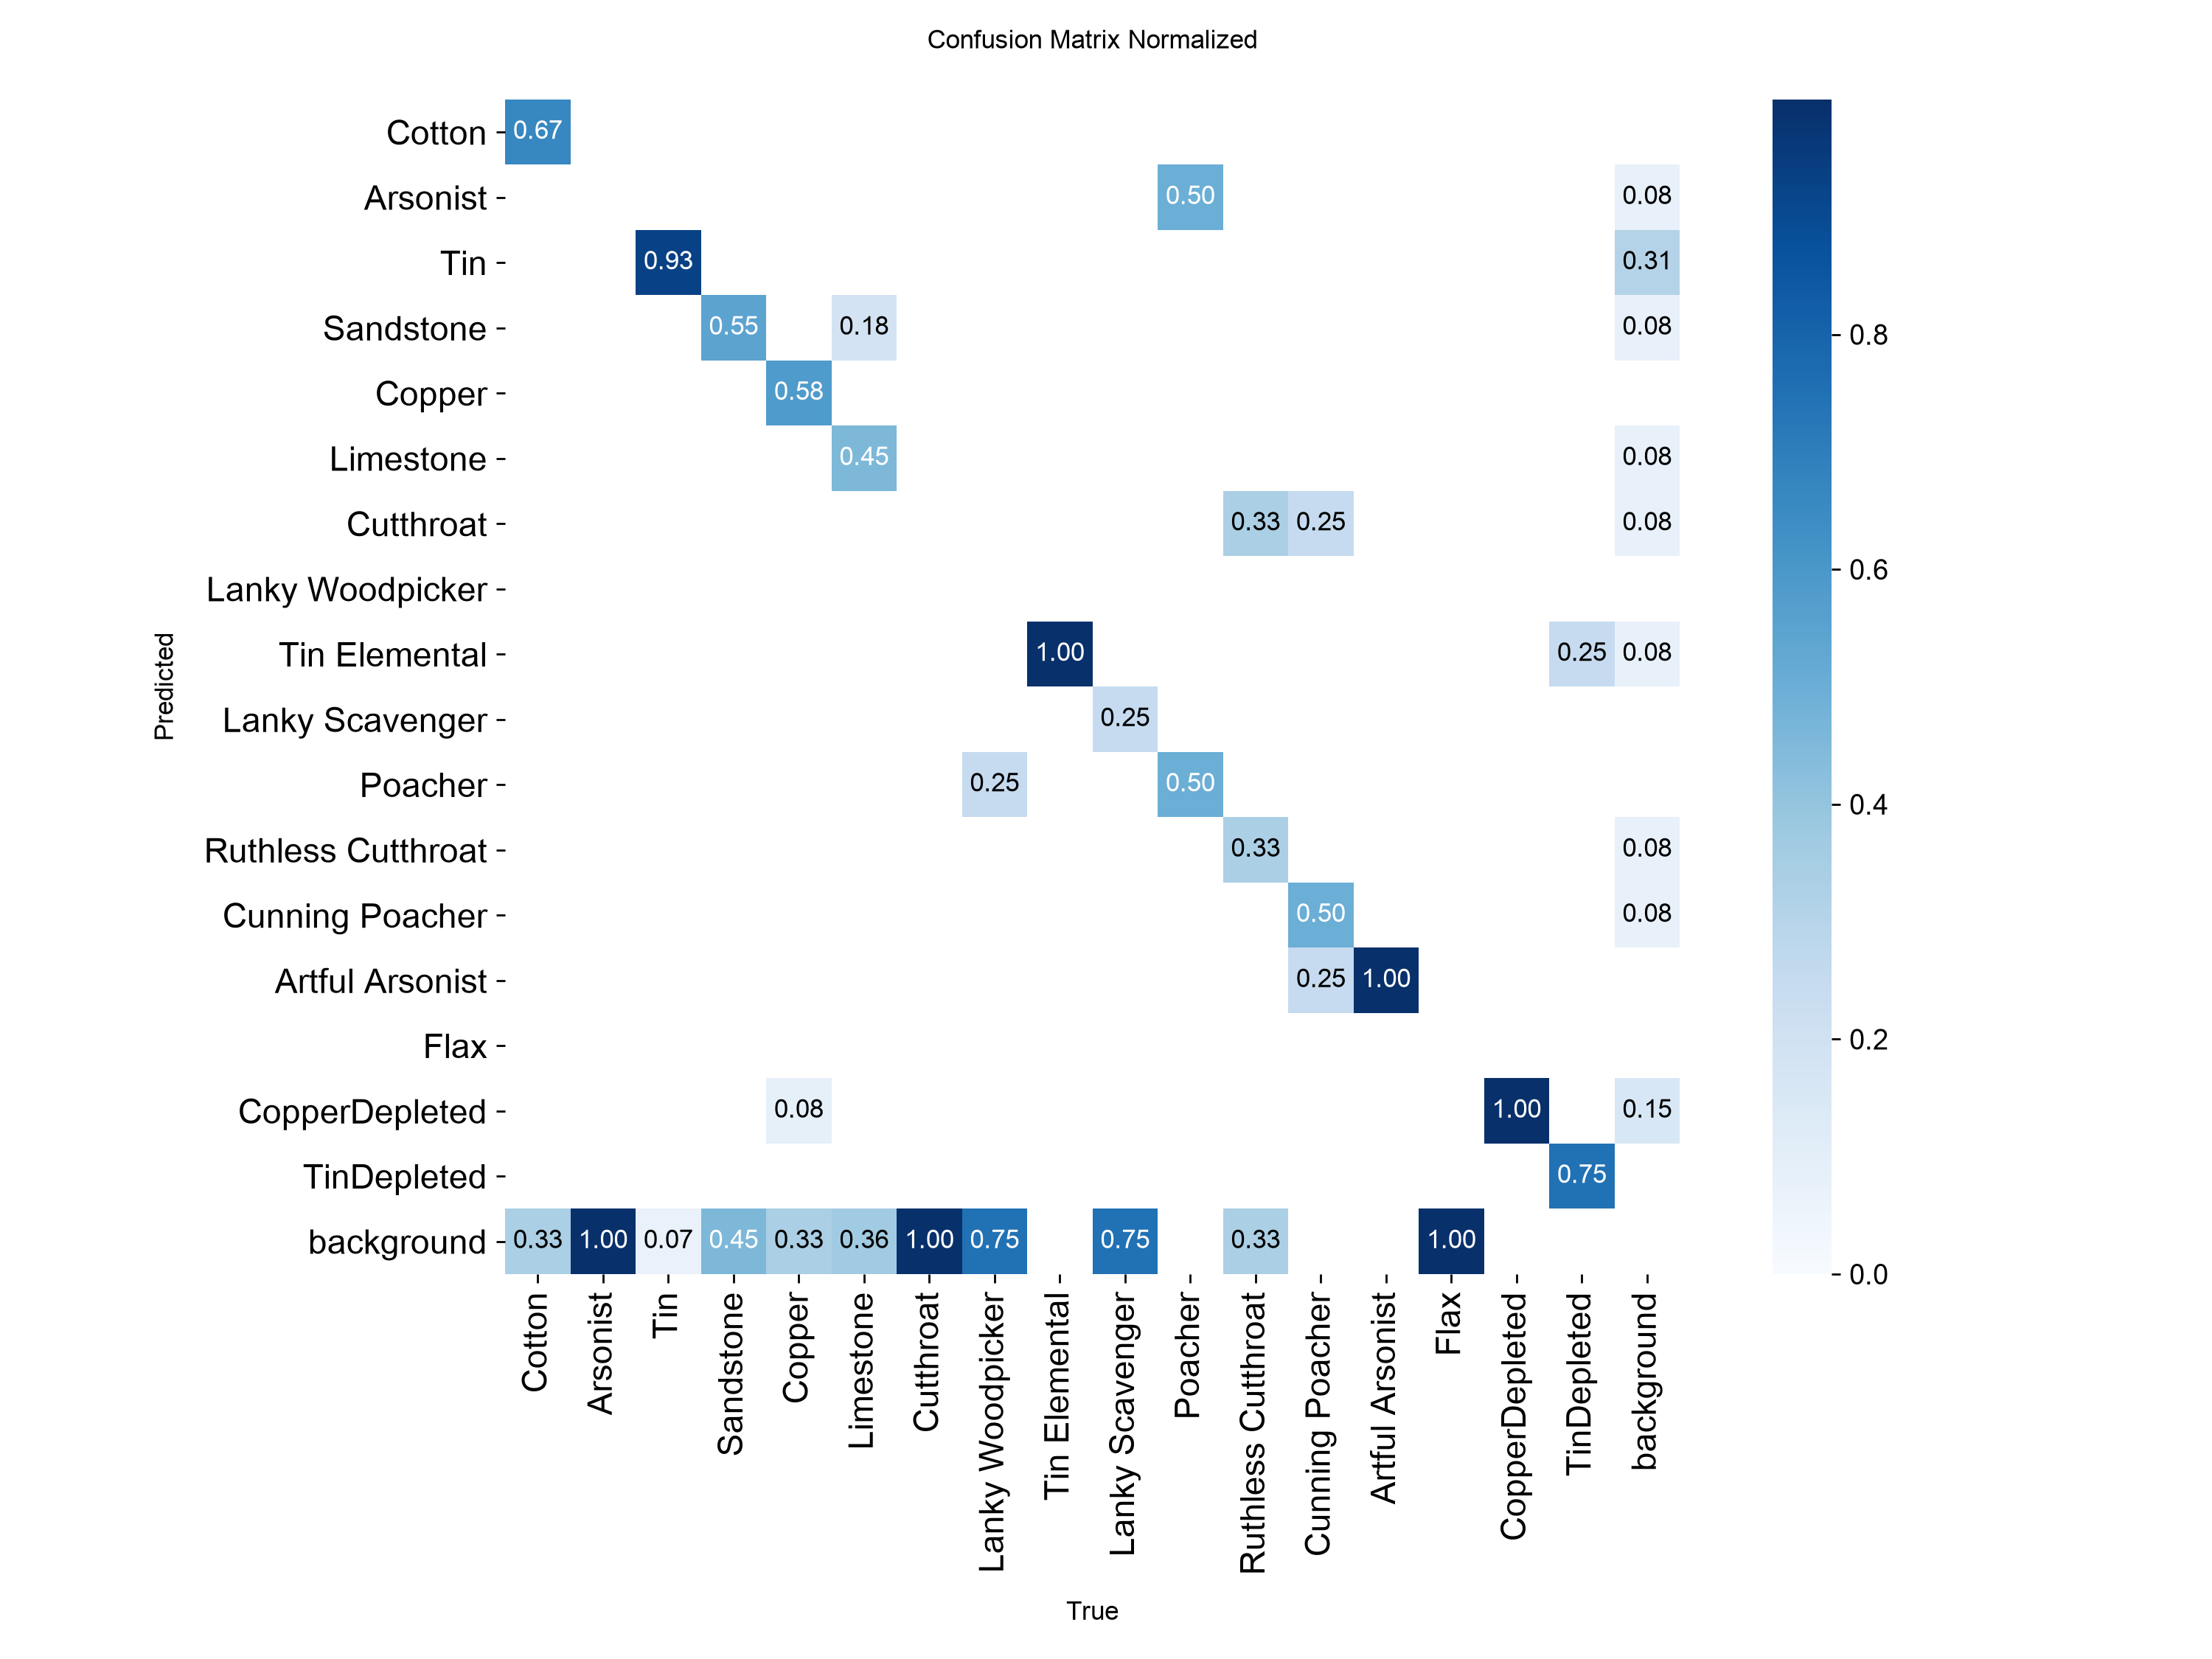
)최고의 체크포인트로 사용하고, 보이지 않는 스크린샷에서 예측을 점검하고, 각 클래스를 따로 검토하세요. 높은 글로벌 점수는 약한 희귀 클래스를 숨길 수 있습니다.
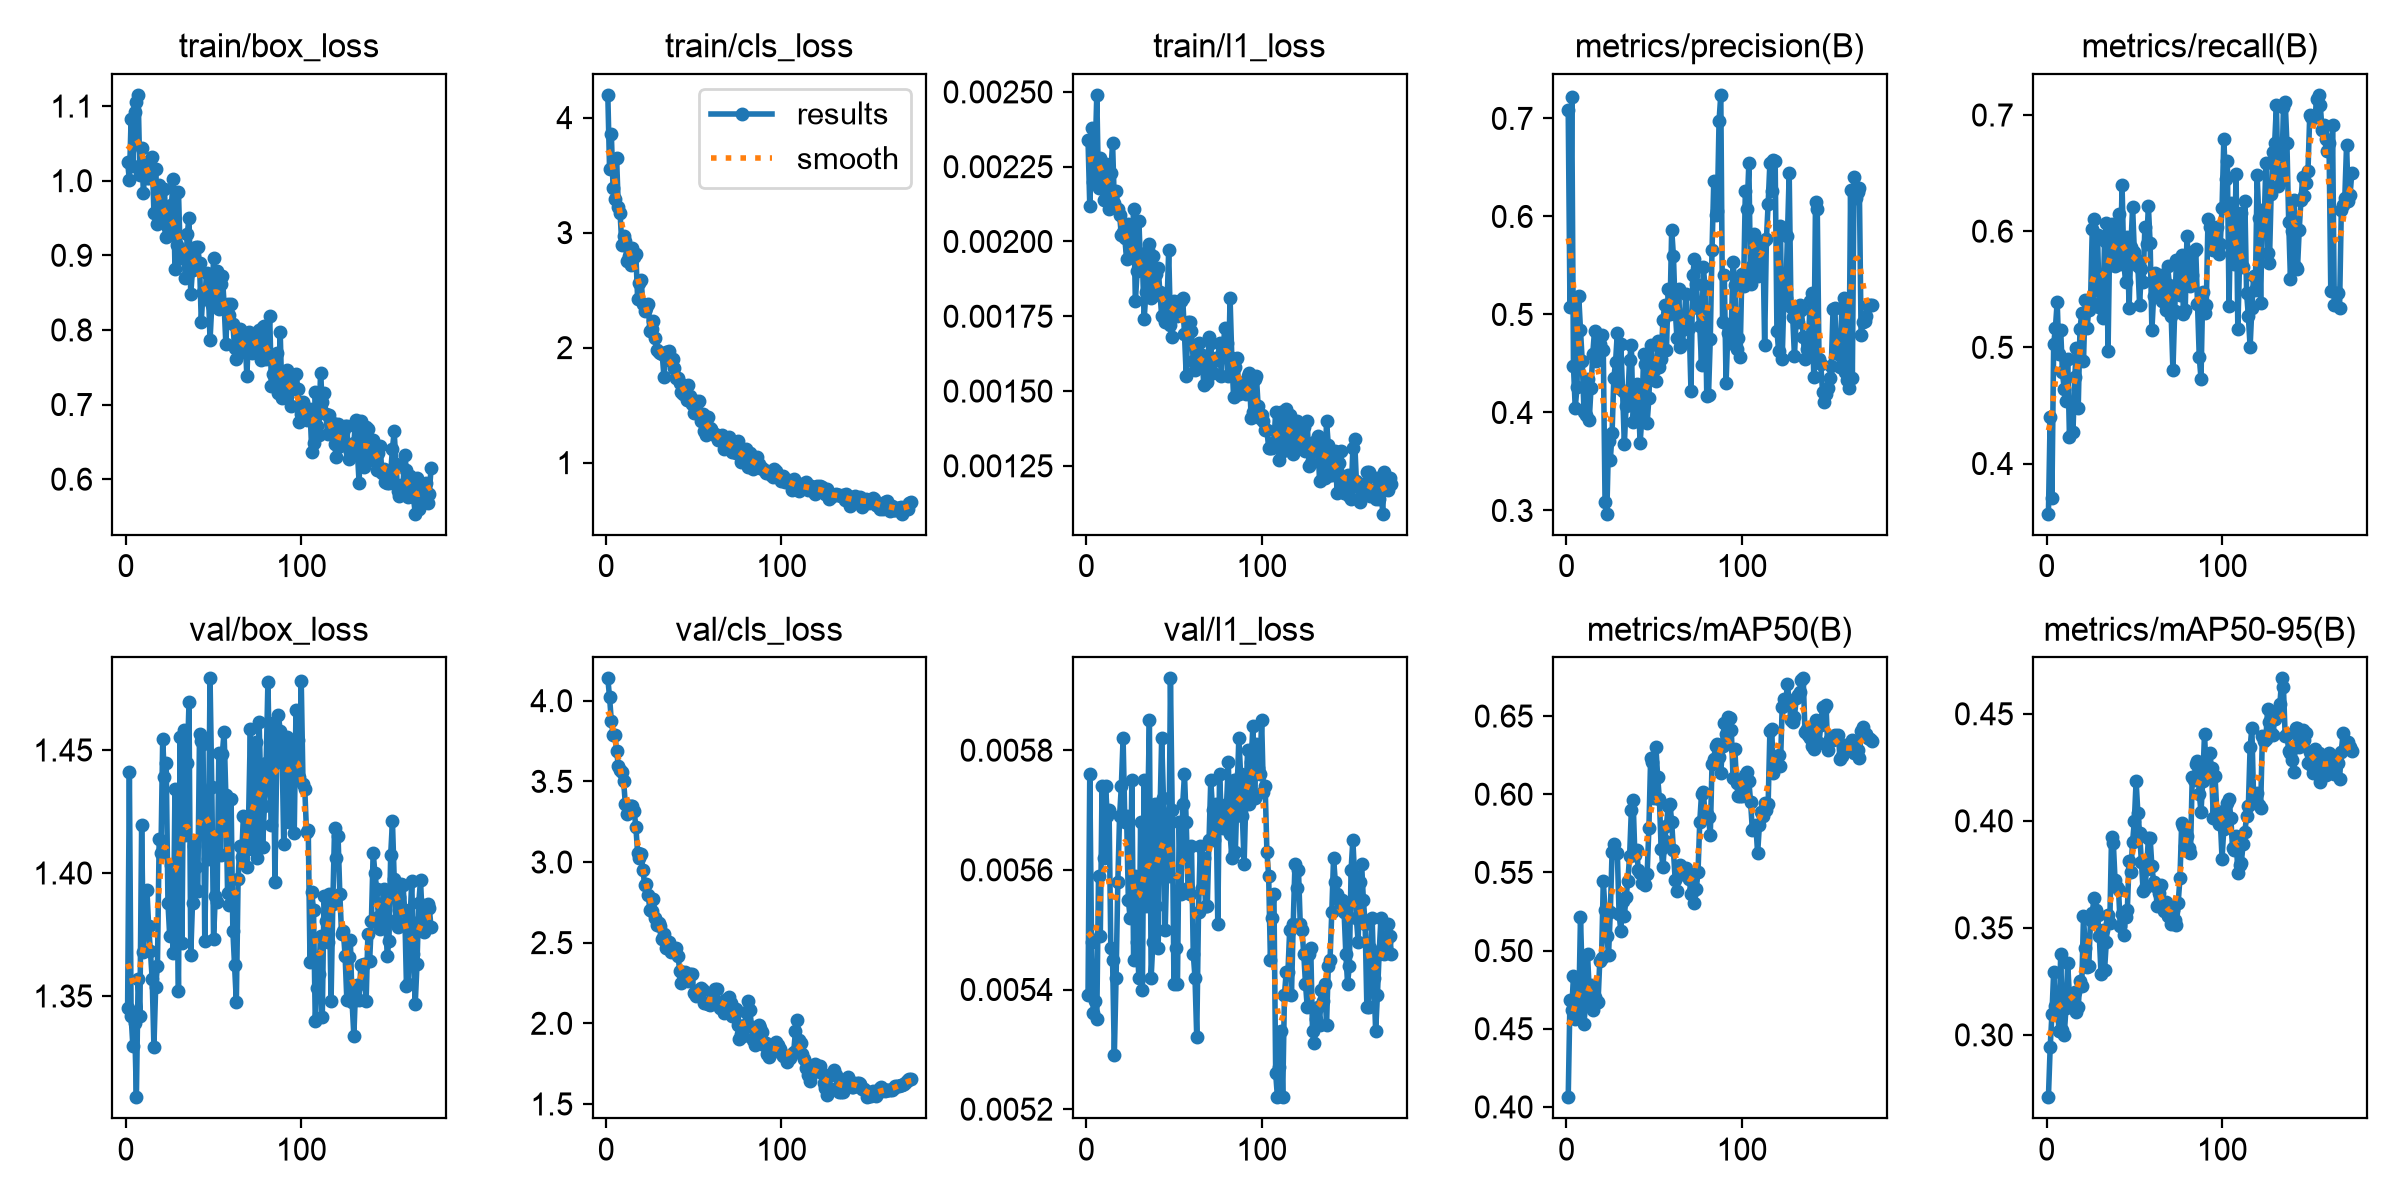
LaiCai는 훈련 .pt 파일을 아니라 ONNX를 가져옵니다. LaiCai가 신뢰도 필터링과 NMS를 적용할 수 있도록 하나의 정적 NCHW RGB 입력, 배치 1, float32 또는 float16, 그리고 원-투-멀리 예측을 한 번에 내보냅니다.
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")
model.export(
    format="onnx",
    imgsz=960,
    batch=1,
    dynamic=False,
    simplify=True,
    nms=None,
)LaiCai의 모델 라이브러리에서 디렉토리를 직접 선택합니다. 디렉토리에 config.json과 modelFile로 이름이 지정된 ONNX 파일이 있어야 합니다. 클래스 ID는 0부터 시작해야 하며 연속되어야 합니다.
game-objects/
├── config.json
└── model.onnx{
"id": "game-objects-v1",
"name": "Game Objects v1",
"type": "yolo",
"modelFile": "model.onnx",
"outputFormat": "raw_yolo_no_objectness",
"id2label": {
"0": "Copper",
"1": "CopperDepleted",
"2": "Wood",
"3": "Monster"
},
"label2id": {
"Copper": 0,
"CopperDepleted": 1,
"Wood": 2,
"Monster": 3
}
}LaiCai가 config.json이 누락되었거나 읽을 수 없다고 말하면, 당신은 ONNX 파일이나 불완전한 폴더를 선택했습니다. 완전한 모델 디렉토리를 가져오고 id2label 또는 label2id가 모든 클래스를 정의하는지 확인하십시오.
열다LaiCai Flow, 모델 라이브러리로 이동하여 준비된 디렉토리를 가져오고, vision.detect에서 사용하기 전에 모델이 호환 가능으로 표시되었는지 확인합니다.
원본 이미지를 저장하세요,YOLO레이블, 클래스 목록, data.yaml, 훈련 명령, 그리고 best.pt가 함께 있습니다. 이 파일들은 당신의 재사용 가능한 데이터셋 소스입니다; 내보낸 ONNX 파일만으로는 신뢰할 수 있는 재훈련을 위해서는 충분하지 않습니다.
아니요. 새 배치에 레이블을 붙이고, 내보내고, 오프라인으로 저장된 기존 데이터셋과 병합합니다. 기존 주석을 수정해야 할 때만 기존 데이터를 다시 가져오세요.
네, 하지만 기존 클래스 뒤에 추가하고 새로운 내보내기를 클래스 이름으로 다시 매핑하세요. 그런 다음 전체 데이터셋에서 다시 훈련하여 기존 클래스가 그대로 나타날 수 있도록 하세요.
두 상태는 시각적으로 유사하며 모델은 그 차이를 배운 적이 없습니다. 별도의 소진 상태 클래스나 검증된 하드 음성 예제를 추가한 다음 다시 훈련하고 혼란 매트릭스를 검토합니다.
아니요. 임계값은 회수의 정확성을 위해 회수를 교환할 수 있지만, 누락된 클래스, 일관성 없는 레이블, 또는 혼란스러운 부정 사례를 대체할 수는 없습니다.
이 가이드의 명령과 호환성 선택은 현재 공식 문서와 LaiCai 모델 계약에 대해 확인되었습니다.
모델이 호환되면 vision.detect를 사용하여 클래스, 임계값 및 화면 영역을 선택하고 성공 또는 실패 경로를 다음 Flow 작업에 연결합니다.