開始之前
當萊彩需要知道目標在畫面中的位置時,應選擇物件偵測。圖片分類只能判斷整張圖片包含什麼,不會回傳目標框。
本教學會帶你從原始截圖一路完成萊彩可用的 ONNX 模型。範例來自小目標遊戲資料集,但相同流程也適用於 App 按鈕、商品、圖示、工具與其他畫面目標。
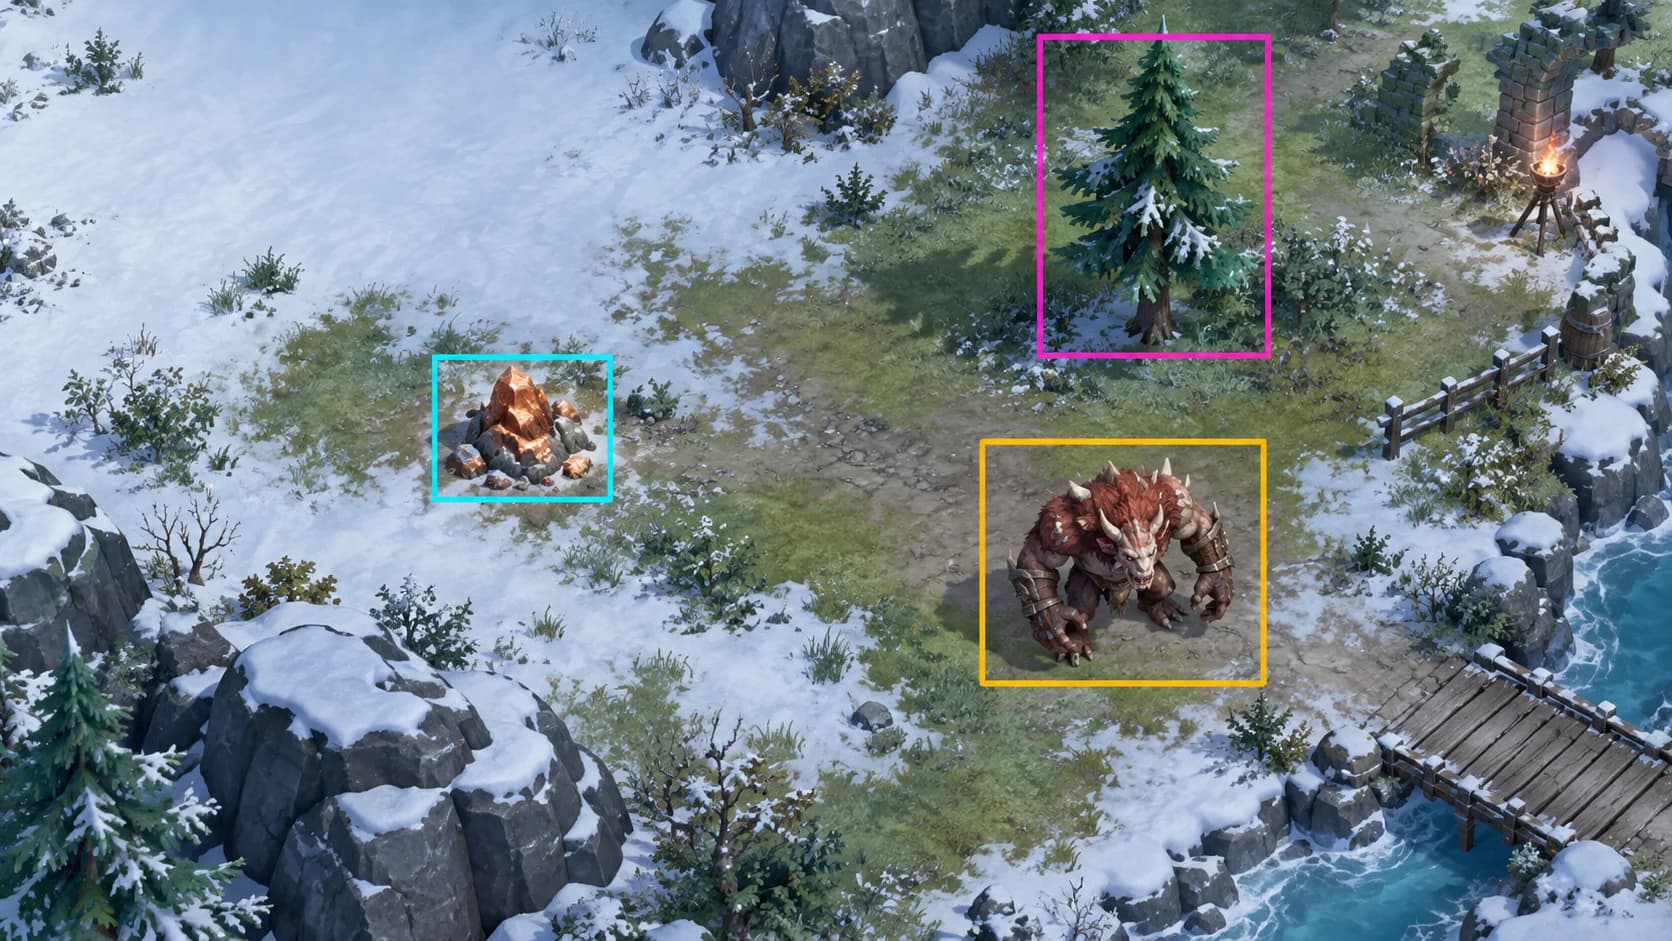
當萊彩需要知道目標在畫面中的位置時,應選擇物件偵測。圖片分類只能判斷整張圖片包含什麼,不會回傳目標框。
通常可以。只要它們出現在同一款遊戲或 App、截圖比例一致,並且需要在同一個 Flow 裡辨識,就適合放進一個模型。只有場景完全無關、類別非常多,或某一組目標需要不同輸入尺寸與效能目標時,才考慮拆分模型。
使用萊彩實際會看到的裝置、解析度、縮放與畫質來擷取。畫面的多樣性,比從影片連續儲存大量幾乎相同的影格更重要。
每個類別都應對應 Flow 需要做出的一個視覺判斷。名稱要短、唯一且保持不變,因為 YOLO 標籤、data.yaml、config.json 與 vision.detect 類別選擇都會使用相同順序。
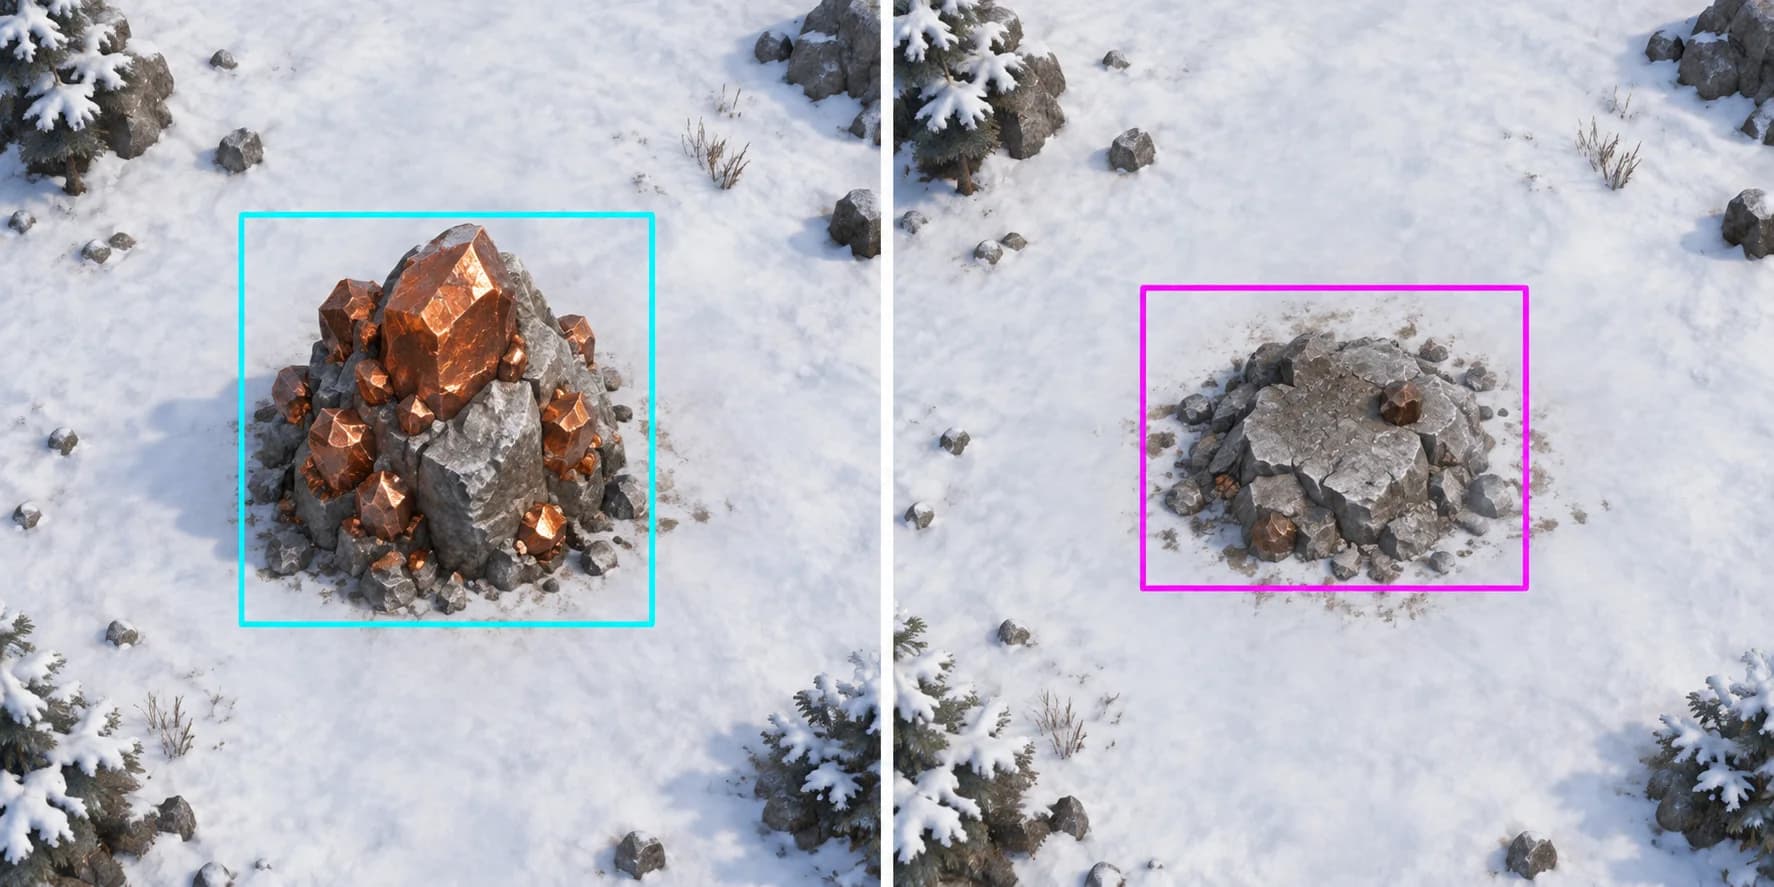
如果資源採集後仍然很像可採集狀態,就把兩種狀態都標出來,例如 Copper 與 CopperDepleted。不要只靠調整信心分數來區分兩個真實視覺狀態。
MakeSense.ai 是免費的瀏覽器標註工具。為萊彩製作模型時,應選擇 Object Detection、使用矩形框,並匯出 YOLO 標註。
開啟 MakeSense.ai 並上傳原始圖片。原圖資料夾要自行保留;匯出的標籤 ZIP 不能取代原圖。
選擇 Object Detection,不要選擇 Image Recognition。
依固定順序建立最終類別表,再為每一個目標實例畫矩形框。
匯出前檢查空圖片、漏標、錯標與過鬆的框。
將 Rect annotations 匯出為 YOLO 格式 ZIP。
每張圖片都要有一個同名 .txt 標籤檔。訓練集與驗證集應依錄影批次或時間區段切分,不要把相鄰影片影格隨機分散到兩邊。
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── data.yamlpath: /absolute/path/to/dataset
train: images/train
val: images/val
names:
0: Copper
1: CopperDepleted
2: Wood
3: Monster第一次可從 80% 訓練、20% 驗證開始。驗證集必須包含訓練時真正沒有看過的場景。
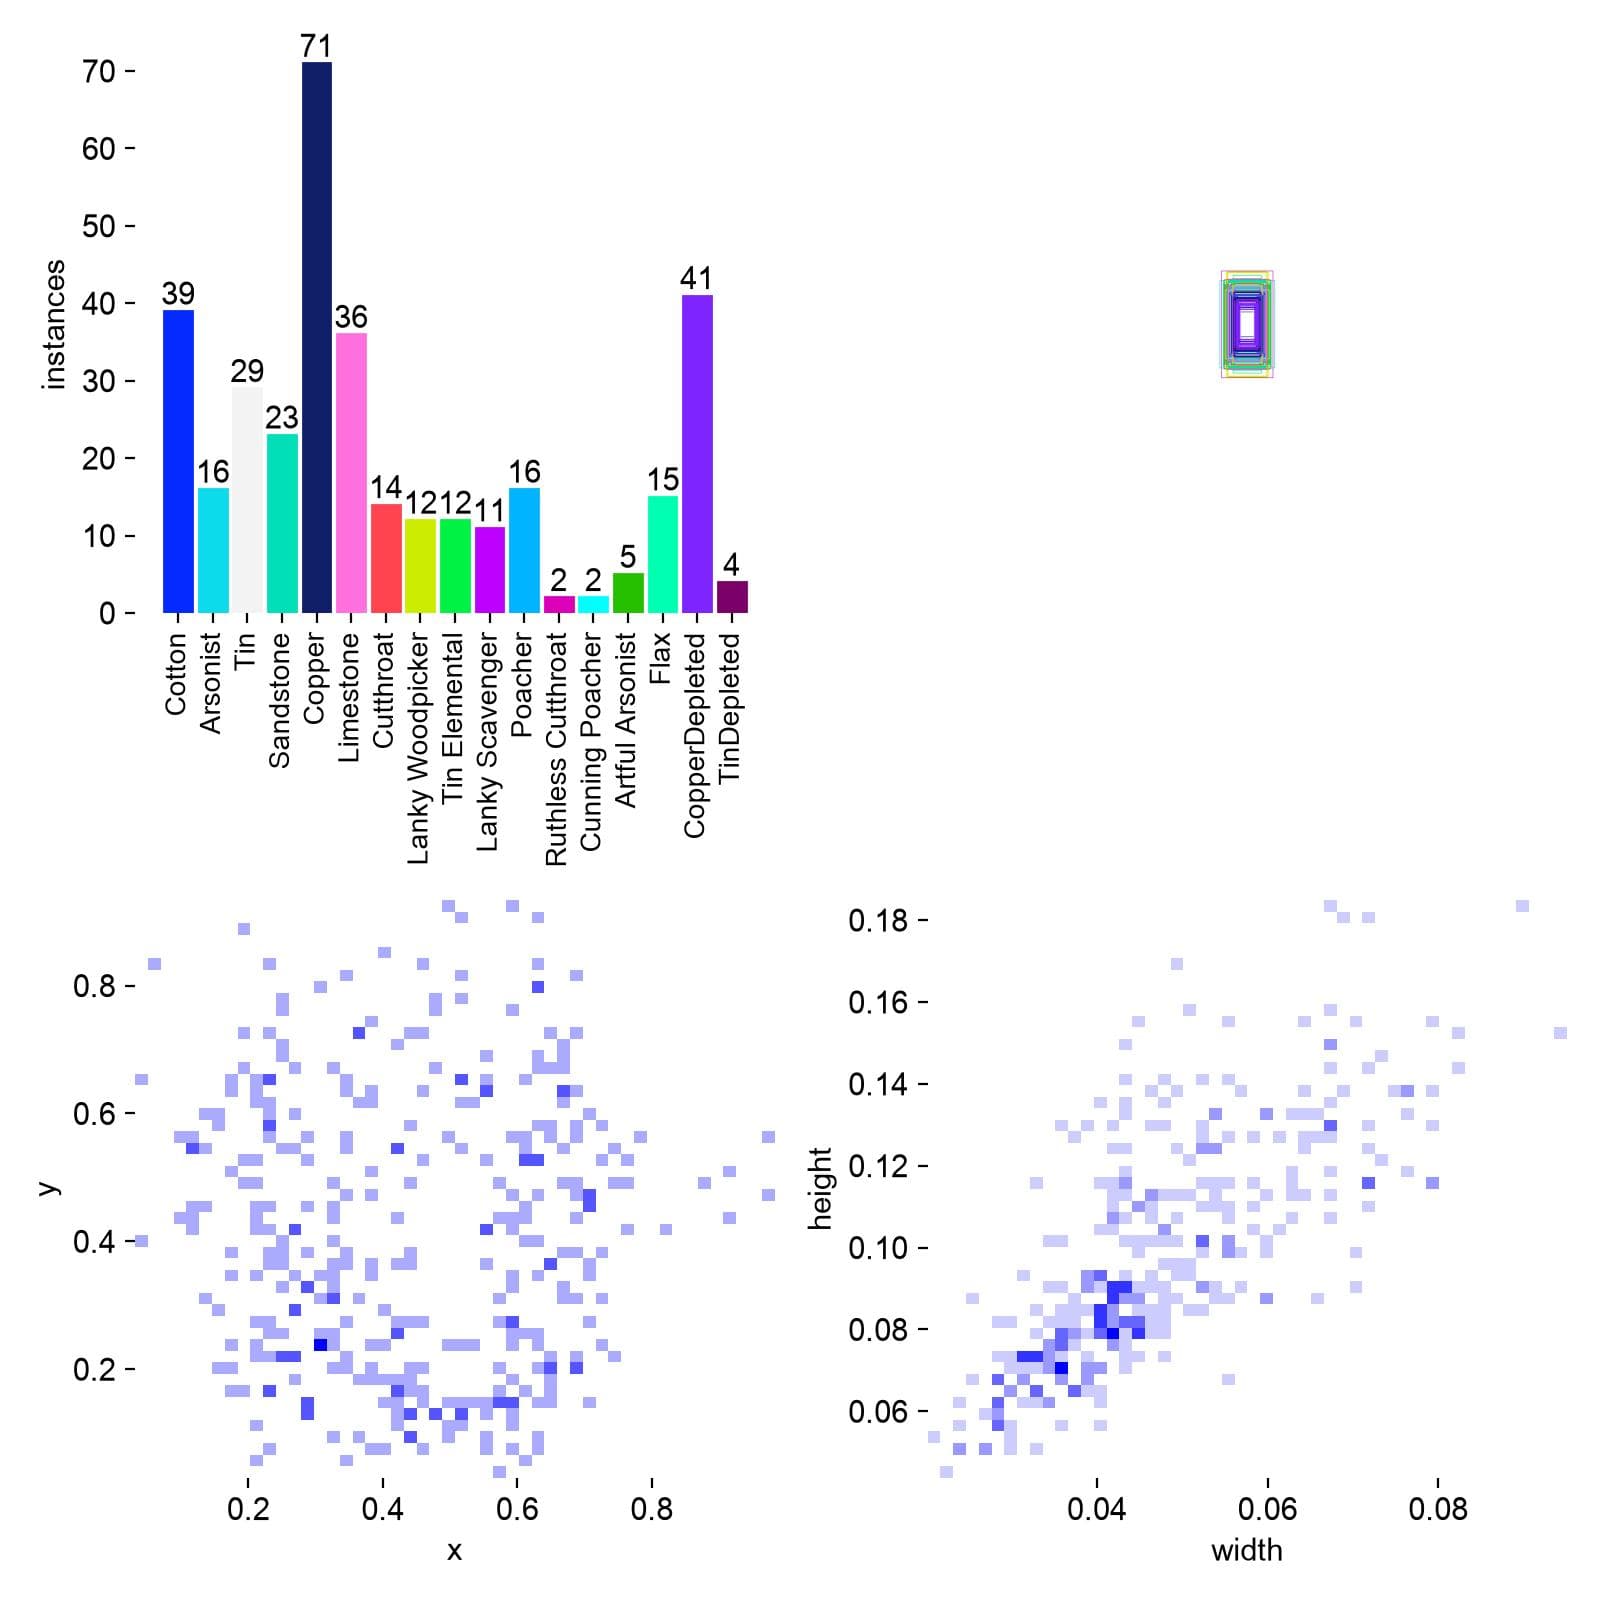
以下使用這套流程已驗證的版本。持續偵測建議先從 Nano 模型開始;目標較大時用 640,重要目標很小時可用 960。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install ultralytics==8.4.138 onnx==1.22.0 \
onnxruntime==1.29.0 onnxslim==0.1.96| 參數 | 起始值 | 原因 |
|---|---|---|
model | YOLO26n | 體積小、速度快,適合第一輪驗證。 |
imgsz | 960 / 640 | 小目標使用 960;目標較大或更重視速度時使用 640。 |
epochs | 200 | 提供充足訓練上限,同時允許提早停止。 |
patience | 40 | 驗證指標連續 40 個 epoch 沒有改善就停止。 |
batch | 8 | 記憶體不足時先降到 4 或 2;只在實際量測後提高。 |
device | mps / 0 / cpu | Apple 晶片使用 mps,NVIDIA 使用 0,任何機器都可使用 cpu。 |
workers | 4 | 較保守的跨平台起點。 |
seed | 42 | 方便重現與比較資料集及不同訓練版本。 |
close_mosaic | 15 | 最後階段關閉 mosaic,讓模型在更自然的圖片上收尾。 |
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="dataset/data.yaml",
    imgsz=960,
    epochs=200,
    patience=40,
    batch=8,
    device="mps",  # NVIDIA: 0 · CPU: "cpu"
    workers=4,
    seed=42,
    close_mosaic=15,
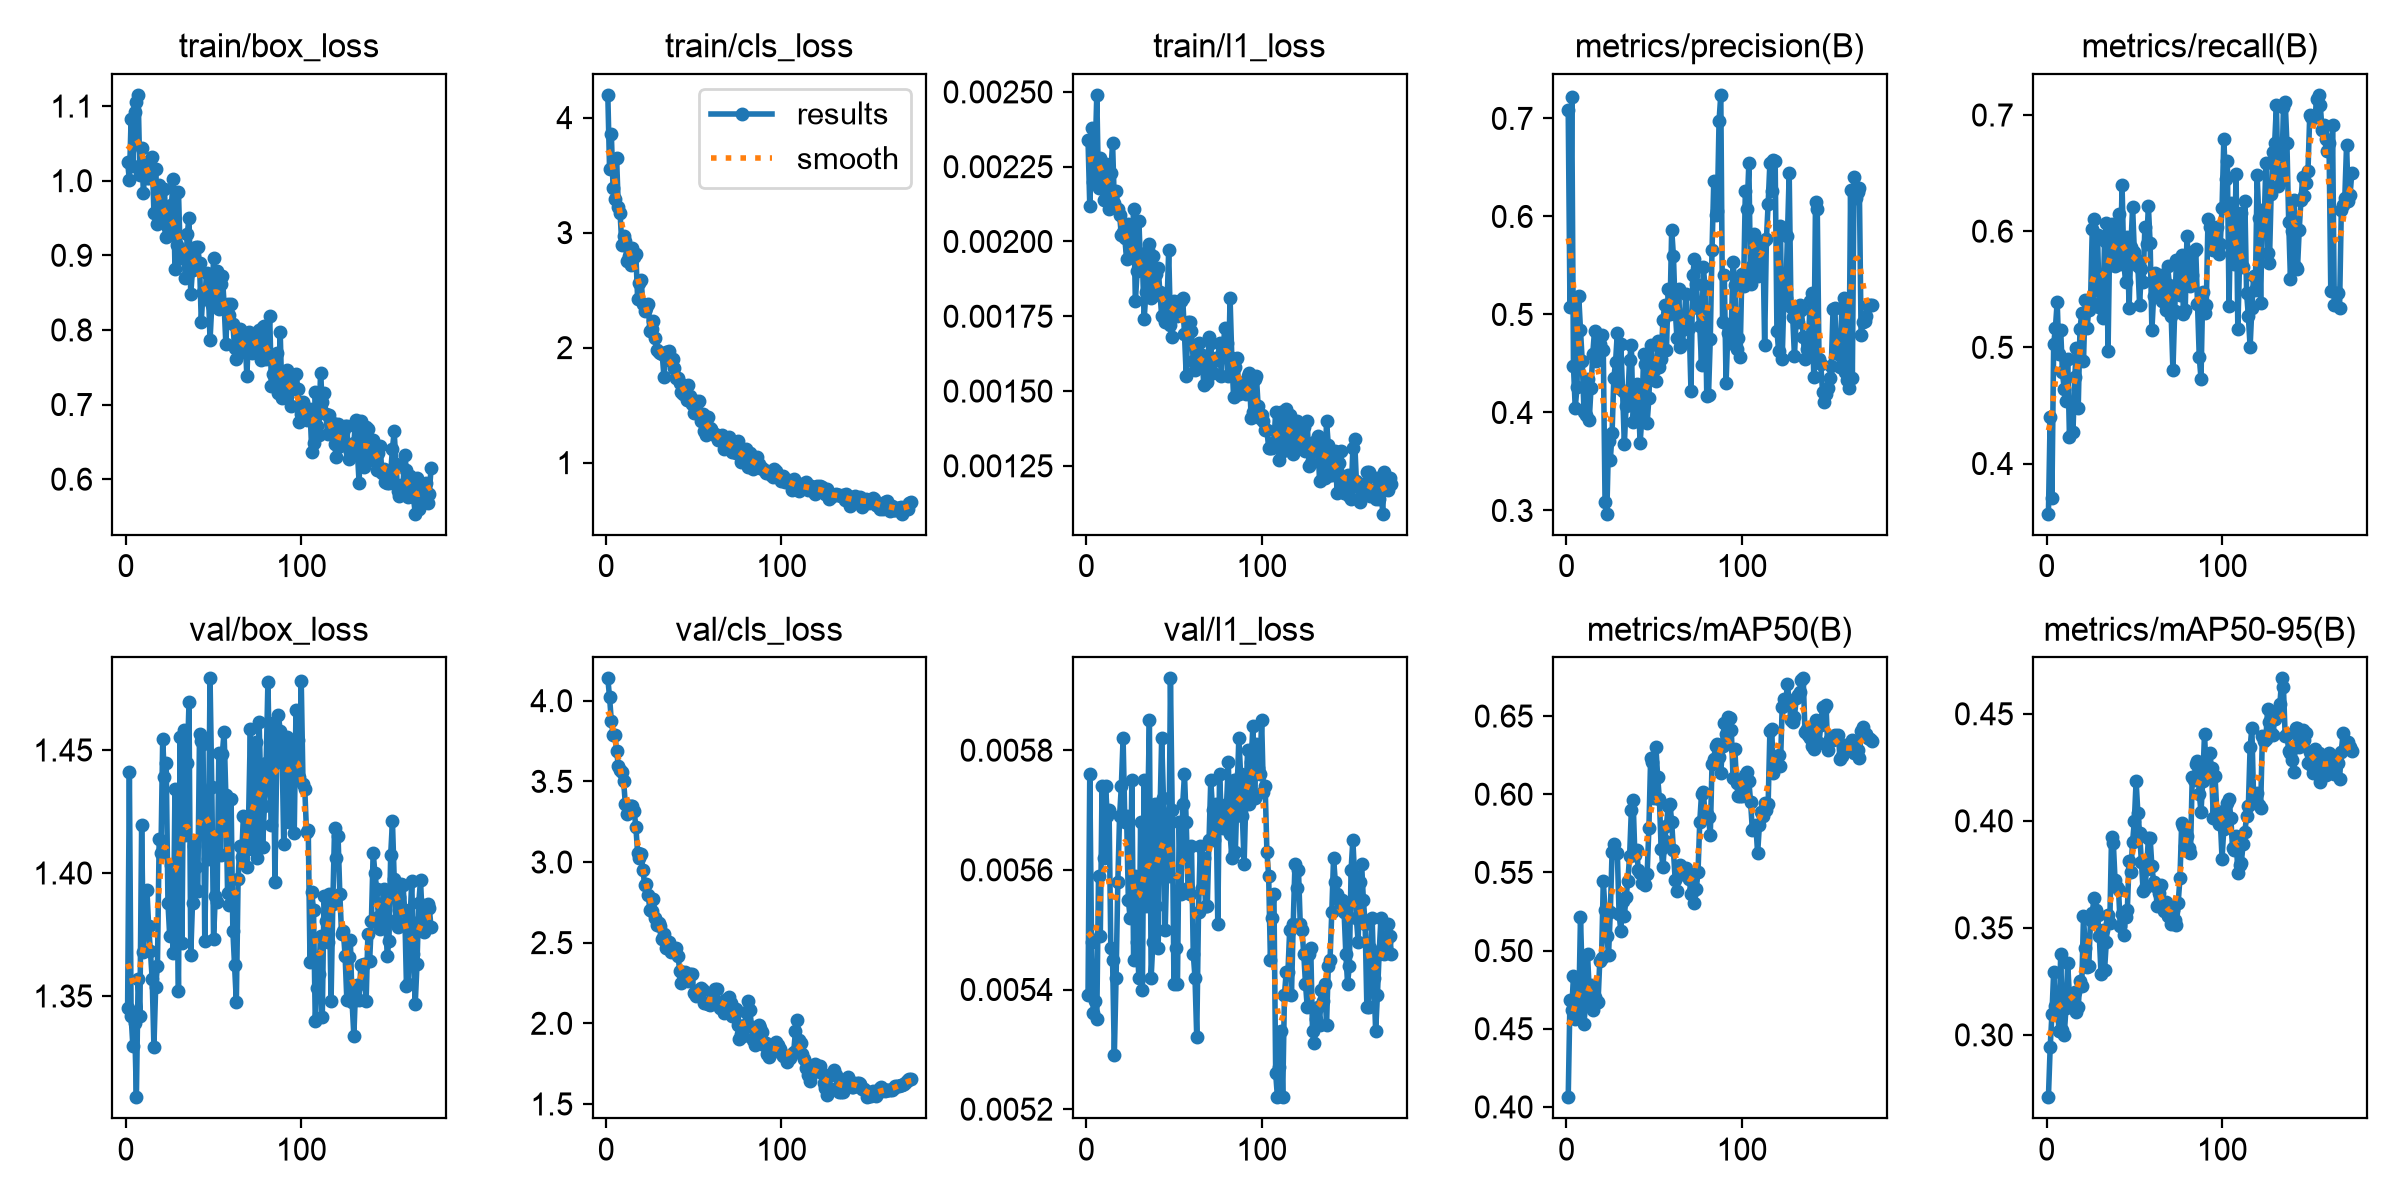
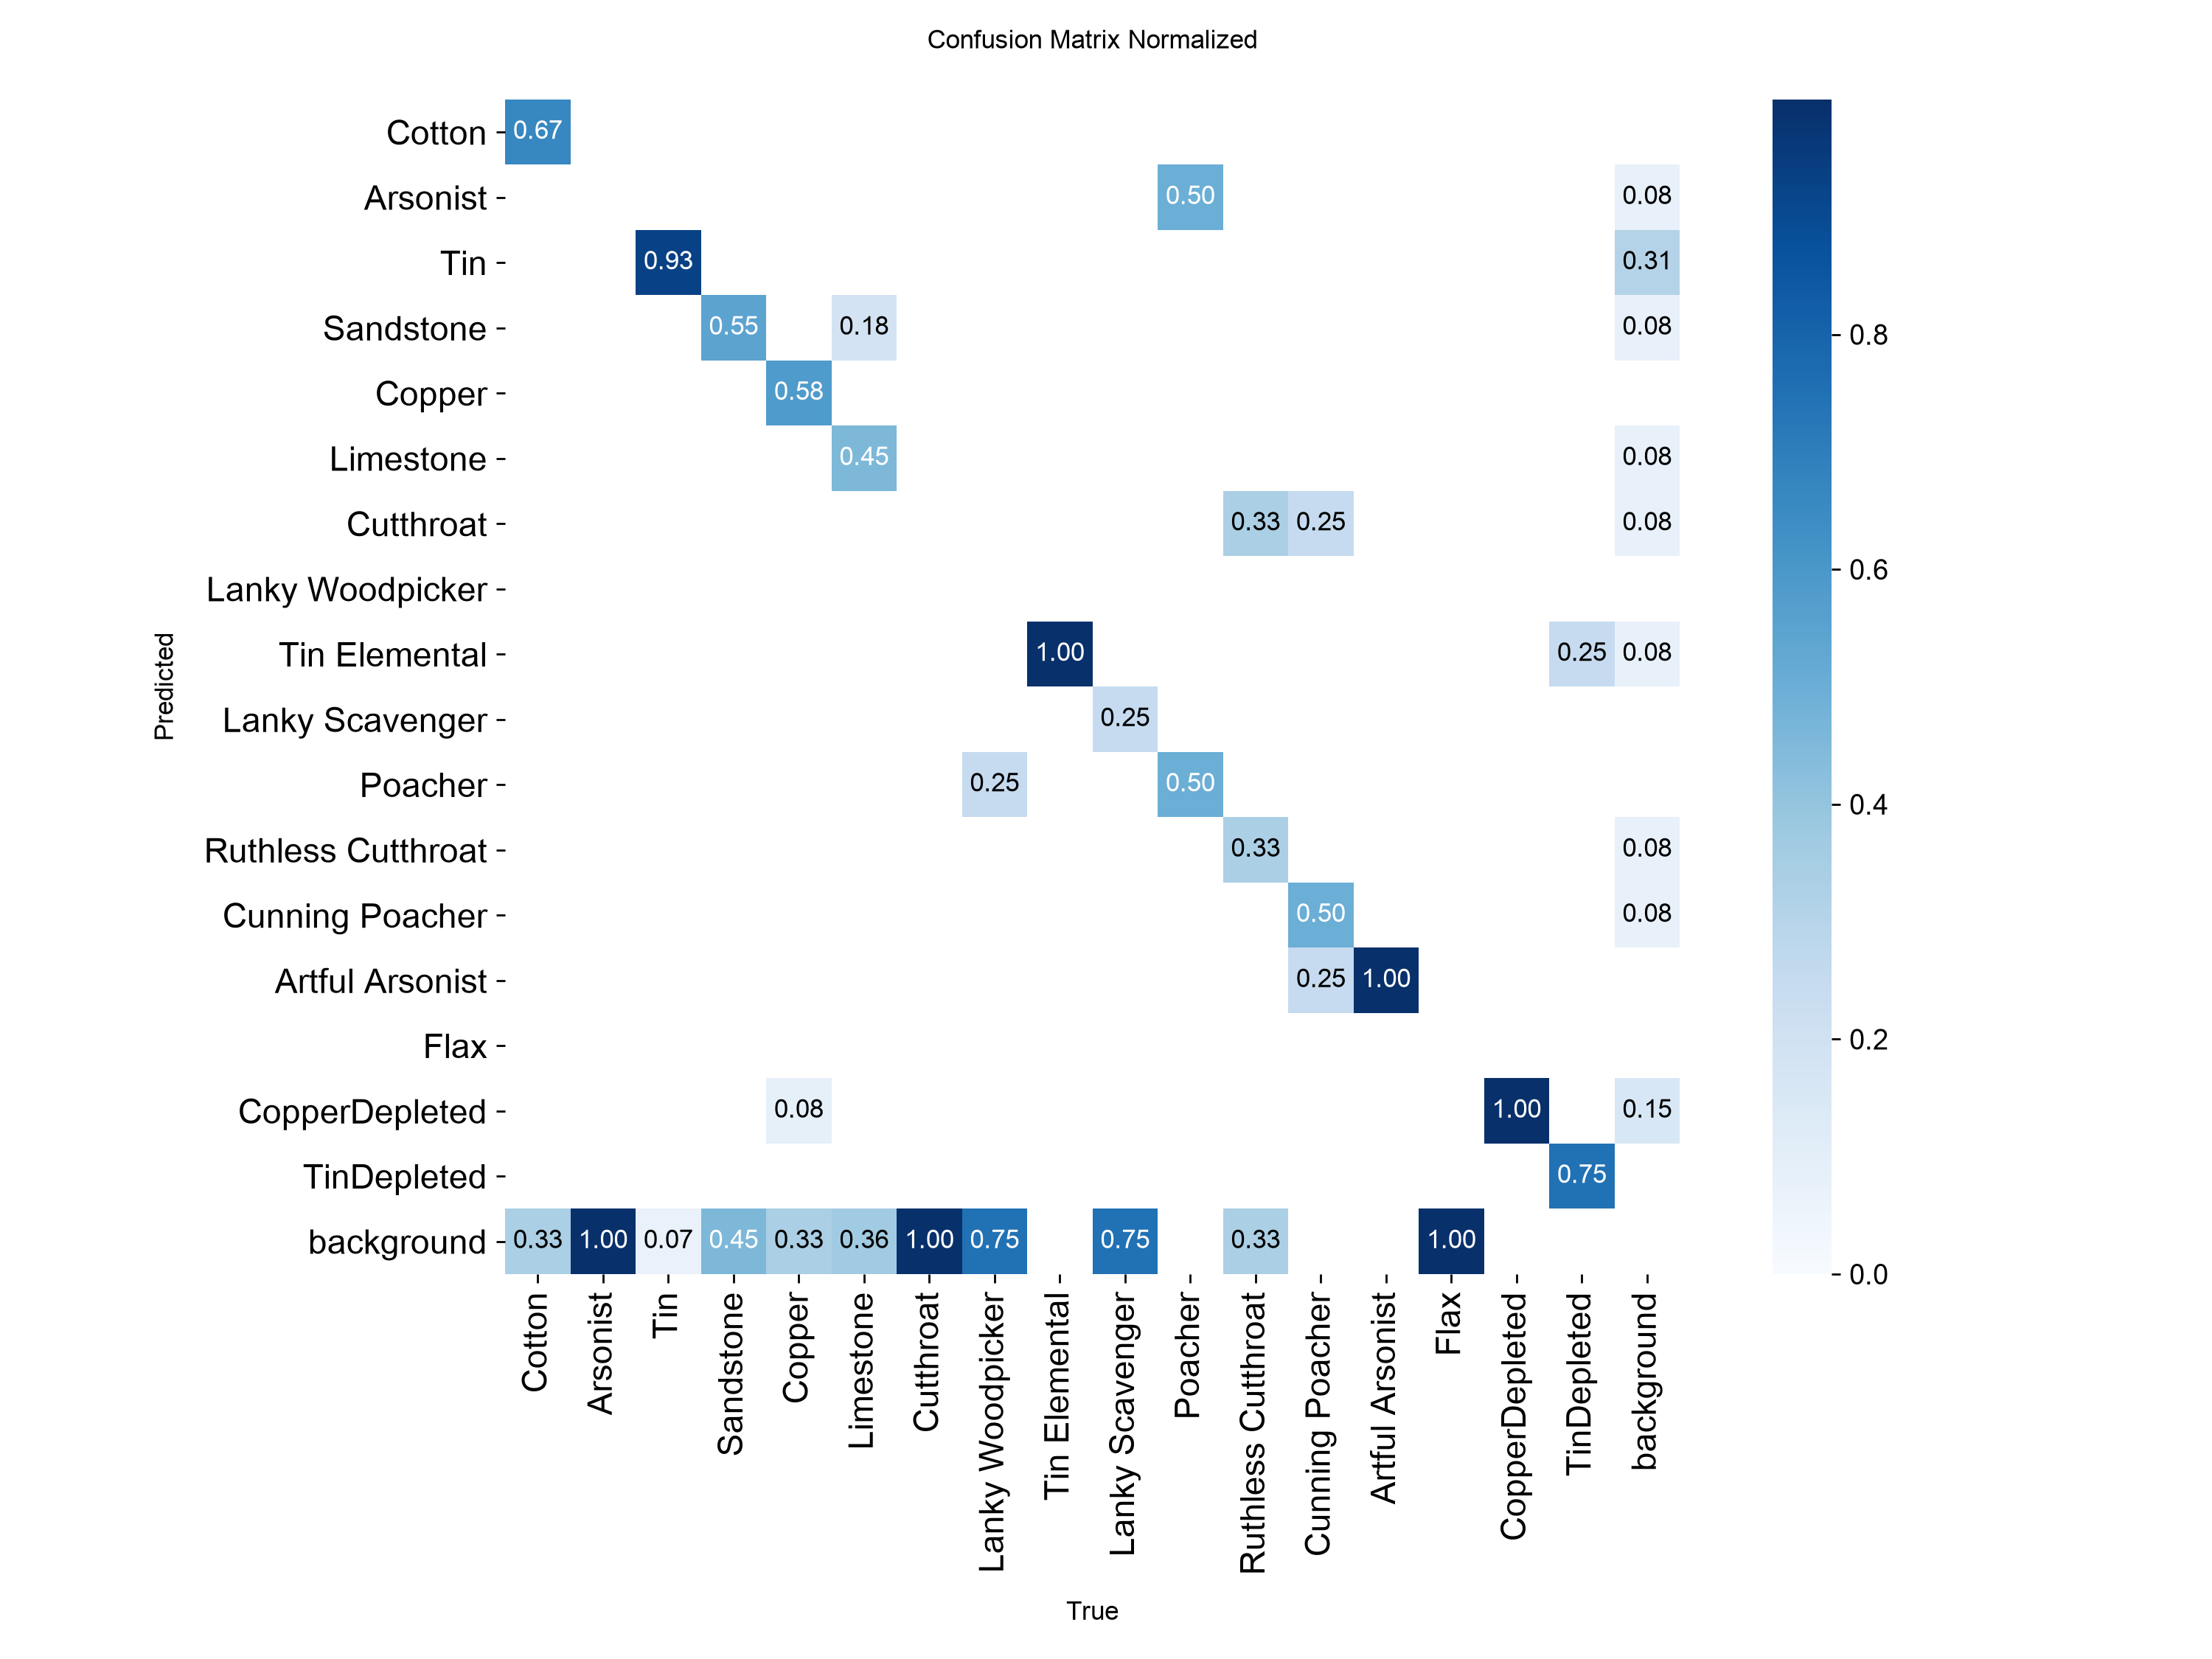
)使用最佳 checkpoint,在未見過的截圖上檢查預測,並分別查看每一個類別。整體高分可能掩蓋某個稀有類別很弱。
萊彩匯入的是 ONNX,不是訓練用 .pt。應匯出單一靜態 NCHW RGB 輸入、batch 1、float32 或 float16,以及原始 one-to-many 預測,讓萊彩執行信心分數篩選與 NMS。
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")
model.export(
    format="onnx",
    imgsz=960,
    batch=1,
    dynamic=False,
    simplify=True,
    nms=None,
)在萊彩模型庫中選擇的是整個目錄。目錄內必須同時有 config.json 與 modelFile 指定的 ONNX 檔;類別 ID 必須從 0 開始連續排列。
game-objects/
├── config.json
└── model.onnx{
"id": "game-objects-v1",
"name": "Game Objects v1",
"type": "yolo",
"modelFile": "model.onnx",
"outputFormat": "raw_yolo_no_objectness",
"id2label": {
"0": "Copper",
"1": "CopperDepleted",
"2": "Wood",
"3": "Monster"
},
"label2id": {
"Copper": 0,
"CopperDepleted": 1,
"Wood": 2,
"Monster": 3
}
}若萊彩提示 config.json 遺失或無法讀取,表示你選了單獨的 ONNX 檔,或目錄內容不完整。請匯入完整模型目錄,並確認 id2label 或 label2id 定義所有類別。
開啟萊彩 Flow,進入模型庫,匯入準備好的目錄;確認模型顯示為「相容」後,再用於 vision.detect。
將原圖、YOLO 標籤、類別表、data.yaml、訓練命令與 best.pt 一起保存。這些才是可持續迭代的資料來源;只有匯出的 ONNX,無法可靠重新訓練。
不需要。標註新批次、匯出後,與保存的舊資料集離線合併即可。只有需要修正舊標註時,才重新匯入舊資料。
可以,但要把新類別附加在舊類別後面,並按類別名稱重新對應新匯出的標籤。接著使用完整資料集重新訓練,確保舊類別仍有樣本。
兩種狀態外觀相近,而模型尚未學會區別。增加獨立的已採集狀態類別,或加入確認過的難負樣本,再重新訓練並檢查混淆矩陣。
不行。門檻只能在召回率與精確率之間取捨,不能取代缺失類別、一致的標註規則或容易混淆的負樣本。
本教學中的命令與相容性選擇,已依目前官方文件與萊彩實際模型契約核對。
模型相容後,在 vision.detect 中選擇類別、門檻與畫面區域,再把成功或失敗路徑連接到下一個 Flow 動作。